liurui's blogs

活成期待的样子...

1. PDSCH频域资源分配

PDSCH频域资源分配方式有两种,称为type0type1支持动态和静态配置;动态配置由DCI进行指示,而静态配置通过IE pdsch-Config中参数resourceAllocation指示,如下图所示;
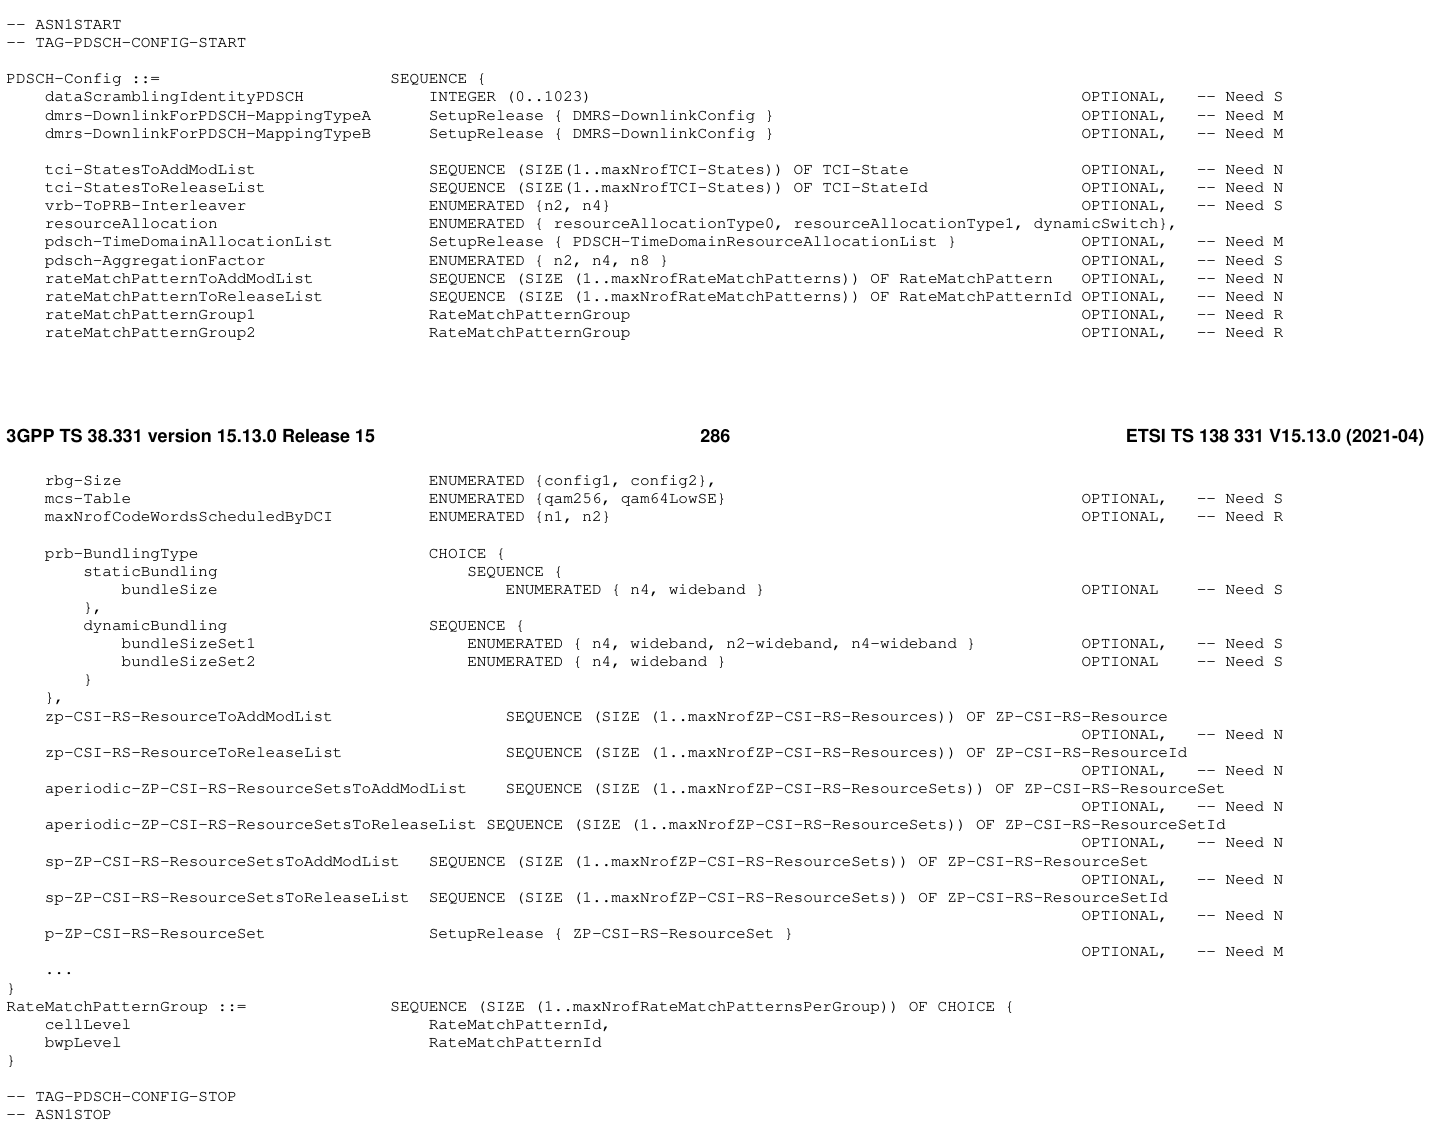
pdsch-config-1

1.1 终端如何获取频域资源分配方式的信息
  • 如果终端通过DCI 1_0接收调度,那么只能是Type 1

  • 如果终端通过DCI 1_1接收调度,需要参考RRC参数配置决定。通过基站在pdsch-Config中配置resourceAllocation来指示UE采用哪种频域资源分配方式,如上表PDSCH-Config所示。如果配置的是dynamicSwitch,UE需要借助DCI中Frequency domain resource assignment的MSB这个bit来判定这次调度是type0还是type1。如果是resourceAllocationType0或者resourceAllocationType1,配的什么就用什么;

1.2 [RB资源起始和RBG size的确定](#RB资源起始和RBG size的确定)
  • RB起始的确定:UE在检测到预期用于UE的PDCCH时将首先确定下行载波BWP,然后确定BWP内的资源分配。如果在DCI中未配置BWP指示符字段或者UE不支持由DCI改变激活BWP,那么在UE激活的BWP内确定用于下行type0和type1资源分配的RB索引。如果DCI中配置了BWP指示符字段并且UE支持由DCI改变激活BWP,则DCI中BWP指示符字段的值指示的UE的BWP内确定用于下行type0和type1资源分配的RB索引。对于PDCCH CSS中由DCI_1_0调度的PDSCH,无论哪个激活BWP,RB编号从接收DCI的CORESET的最低RB开始;否则,RB编号从所确定的下行BWP中的最低RB开始。

  • RBG Size的确定:其由IE PDSCH-Config中参数rbg-Size和当前的BWP带宽决定,如下图所示:rbg-size确定配置类型是configuration 1还是configuration 2,然后再根据当前BWP的大小确认RBG Size。
normal_rbg_size

RBG个数的确定在协议中有如下的定义:RBG-num-1.png

1.3 type0和type1的频域资源分配
  • Type0:是一种频域资源非连续分配的方式,相对灵活:使用bitmap来指示用于分配给终端的频域资源,1表示分配,0表示未分配。每个bit代表一个RBG,RBG是的大小和两个因素相关,一个是当前BWP的大小,二是参数rbg-Size是Configuration 1还是Configuration 2。RBG的index在频域上是从BWP的low frequency向high frequency来计数;

  • Type1:是一种频域资源连续分配的方式:使用RIV的方式告知终端所分配RB的起始位置RB_start和分配了多少个连续的RB,即L_RB;【38214的5.1.2.2.2有RIV计算的过程】。RB_start和L_RB的使用范围:对于DCI 1_0 common search space的情况,此时使用CORESET0的大小 (if CORESET0 configured)或者初始BWP大小(if CORESET0 not configured);对于其他情况使用当前BWP的大小。

终端在收到DCI后,通过其中的的Frequency domain resource assignment这个字段根据结合当前的配置类型,来选择通过Bitmap还是RIV的方式计算到底分配了哪些RB资源。DCI中的Frequency domain resource assignment实际是一串指示rbg或者RB的bitmap或者RIV值。协议中关于Frequency domain resource assignment的描述如下图所示
pdsch-rbg_alloc.png

2. PDSCH时域资源分配

终端需要获取的PDSCH时域资源信息主要有3个,分别是:K0起始symbol和长度Mapping TypeA/B;其中:K0是终端接收到PDCCH DCI调度信息到真正接收PDSCH数据的时间间隔,单位为slot;起始symbol和长度指的是终端需要知道在所调度的slot内那些symbol是属于分配给自己的;Mapping TypeA/B是slot内symbol映射的类型。
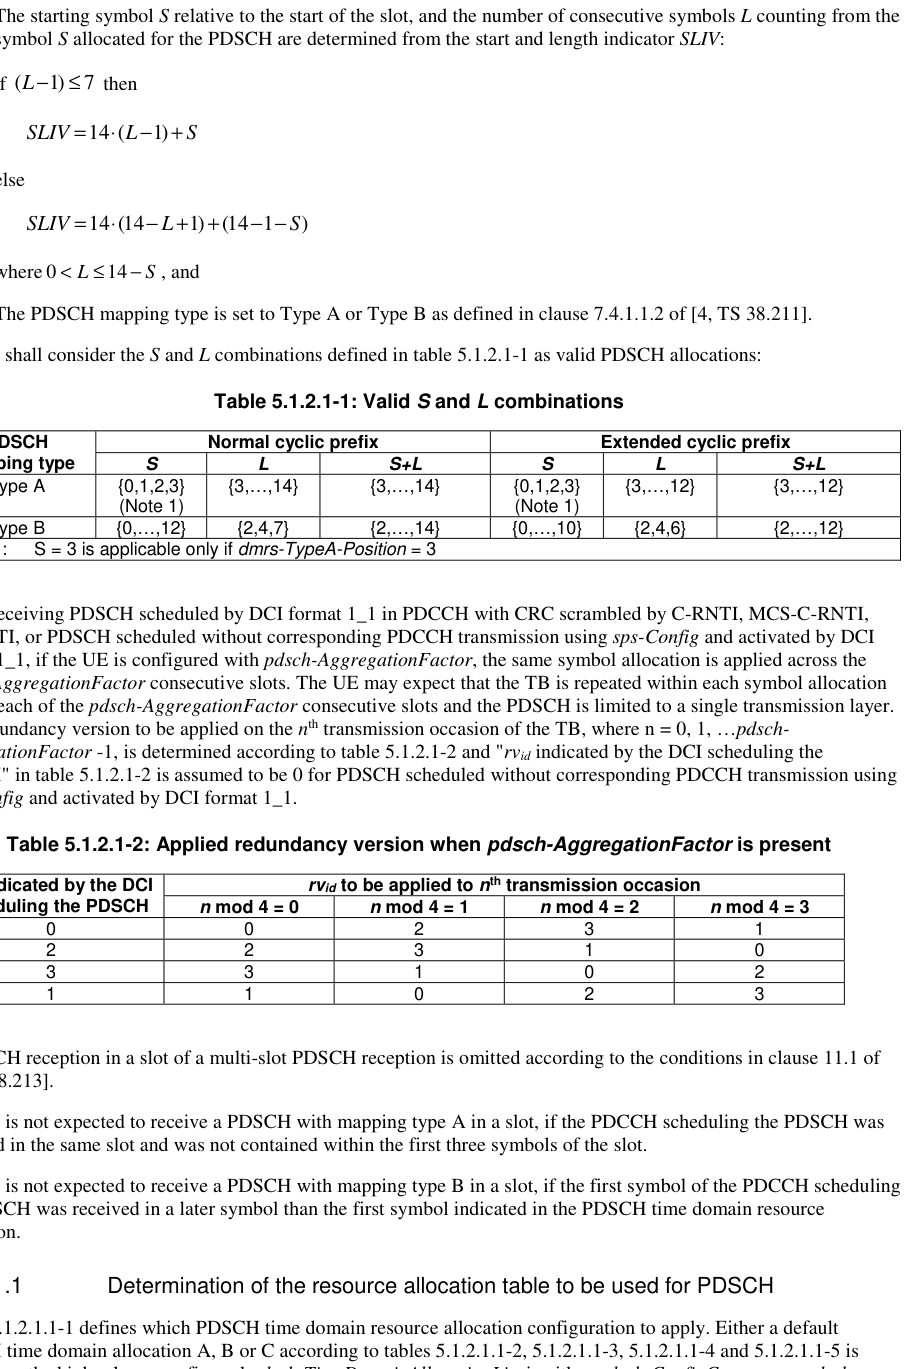
pdsch_mapping_type

2.1 [终端如何获取配置K0、起始symbol和长度和Mapping TypeA/B](#终端如何获取配置K0、起始symbol和长度和Mapping TypeA/B)
  • 通过DCI_1_0/DCI_1_1获取 :在DCI_1_1中,有一个Time domain resource assignment字段, 有0、1、2、3或4bit信息,确定表5.1.2.1.1-2/3/4/5的行索引Row index,协议中的描述如下:
    Time domain resource assignment – 0, 1, 2, 3, or 4 bits as defined in Clause 5.1.2.1 of [6, TS 38.214]. The bitwidth for this field is determined as log2 (I) bits, where I is the number of entries in the higher layer parameter pdsch-TimeDomainAllocationList if the higher layer parameter is configured; otherwise I is the number of entries in the default table.

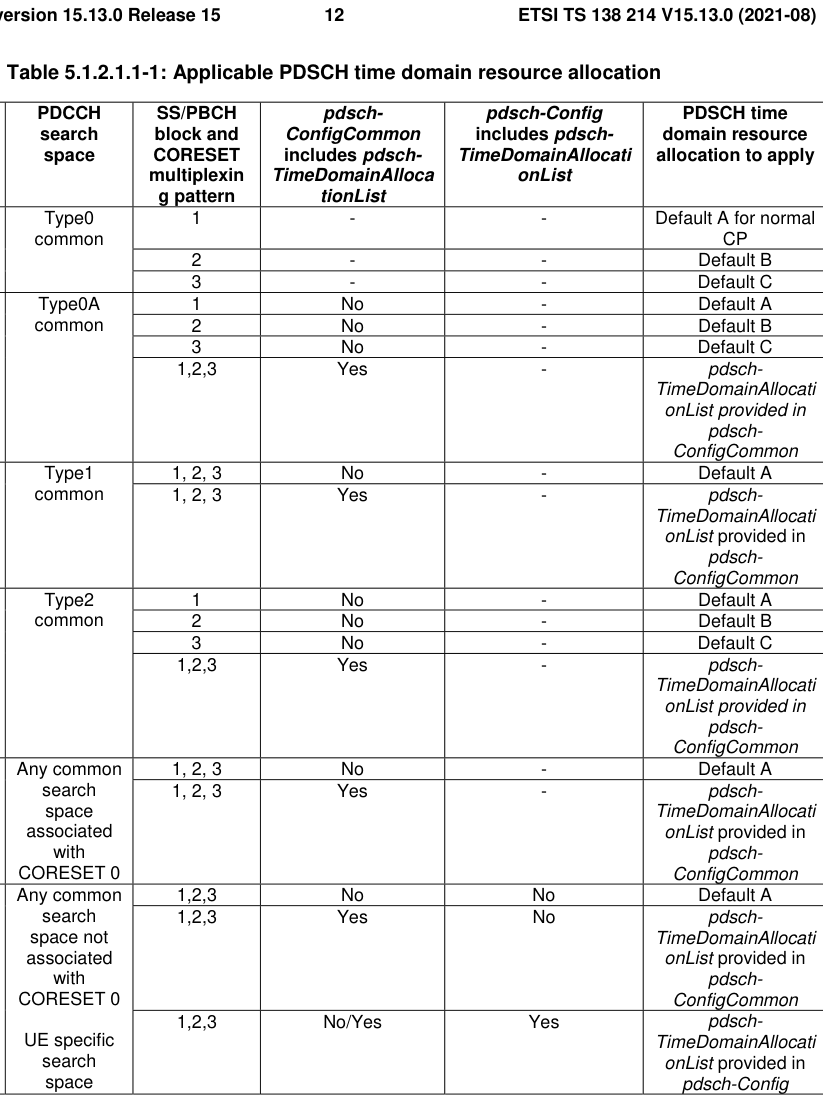
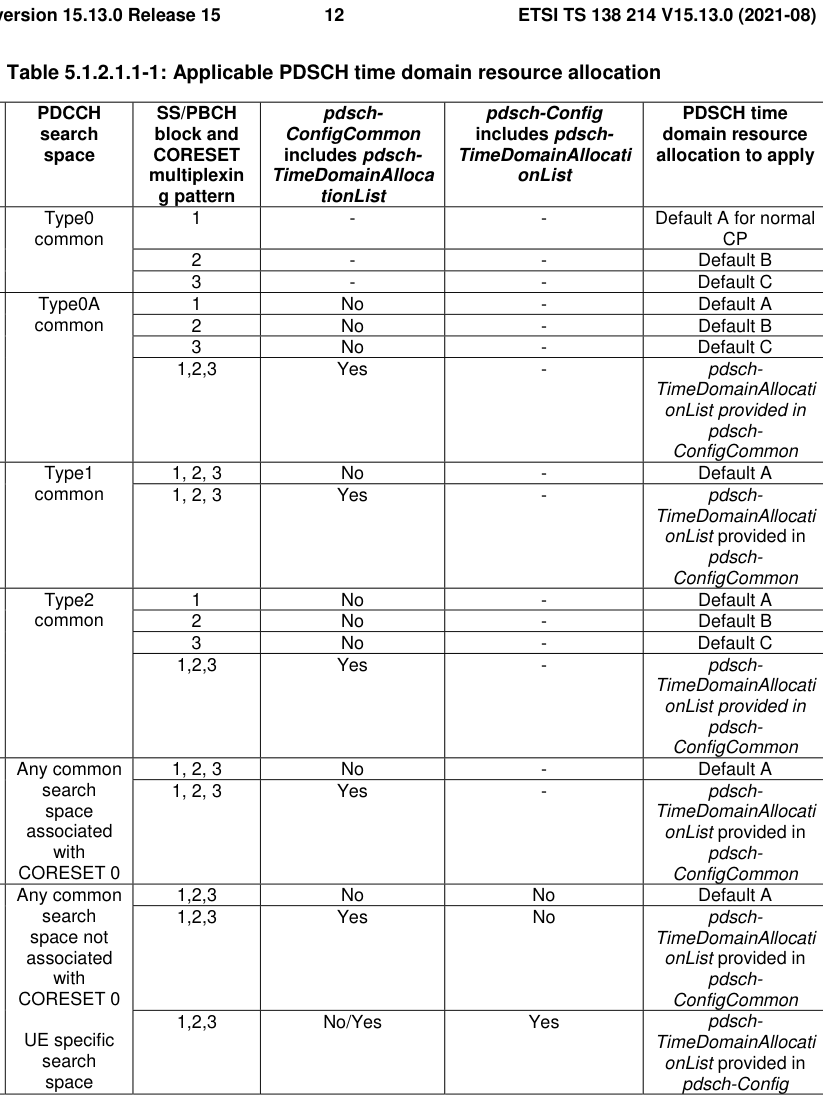
协议38214中表5.1.2.1.1-2/3/4/5给出了PDSCH的时域信息配置表,可以通过row index去获取,表格信息如下图所示:
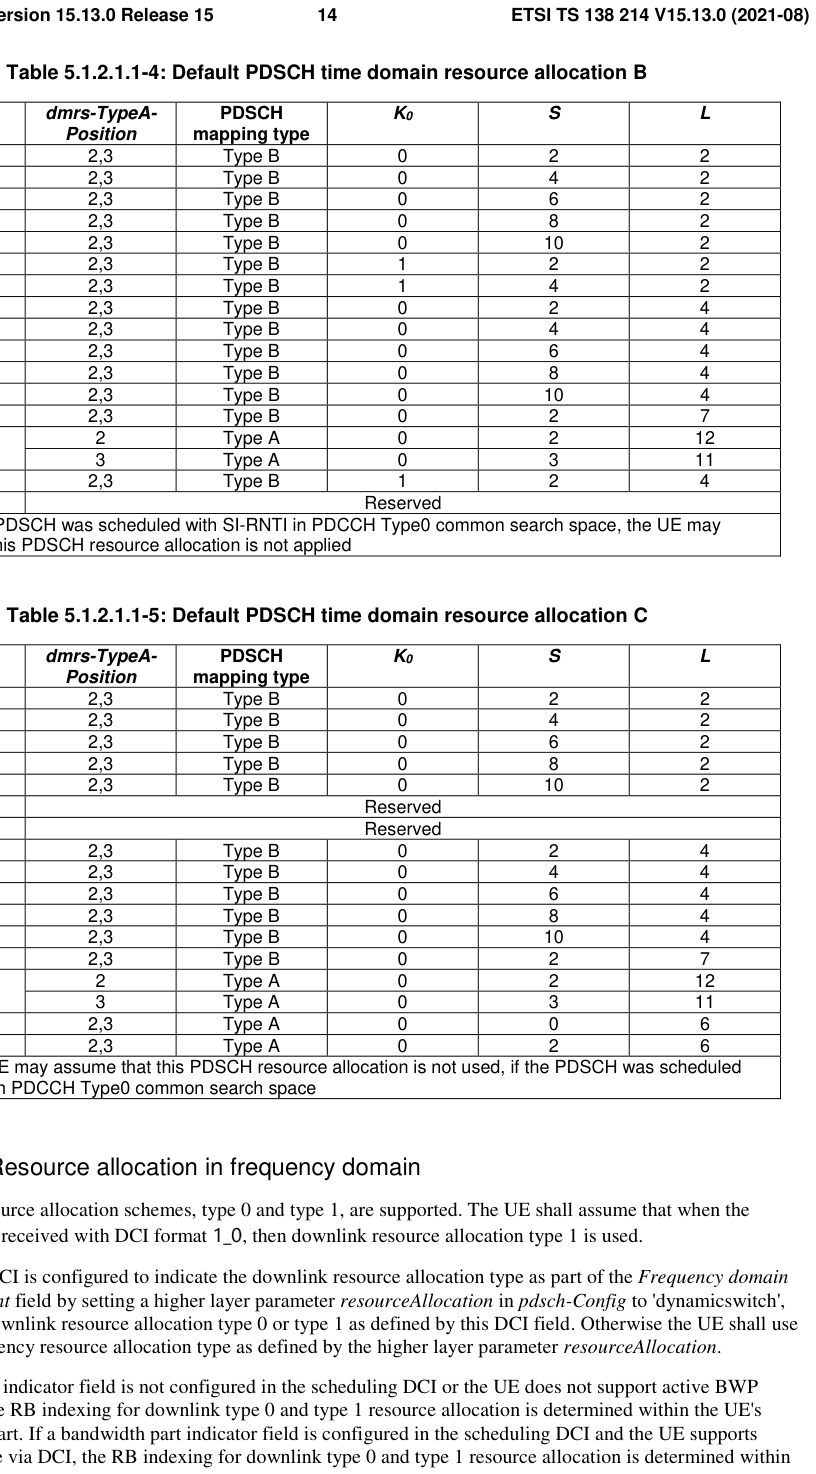
38214_5.1.2.1.1-23.png38214_5.1.2.1.1-45.png

  • 通过pdsch-ConfigCommon或pdsch-Config配置的pdsch-TimeDomainAllocationList获取时域信息,这个参数组中包含多组{K0,mappingType, startSymbolAndLength}的参数组,其中startSymbolAndLength是以SLIV的形式给出的,可以计算出Start Symbol和Length,下图是配置的示例:
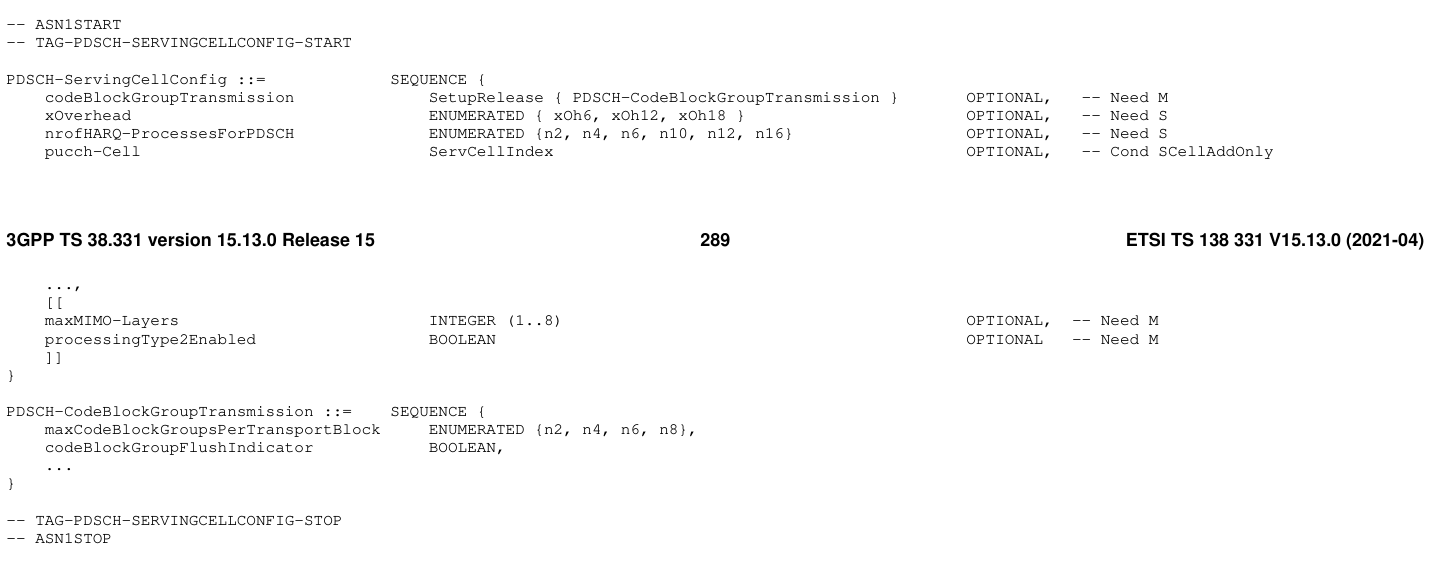
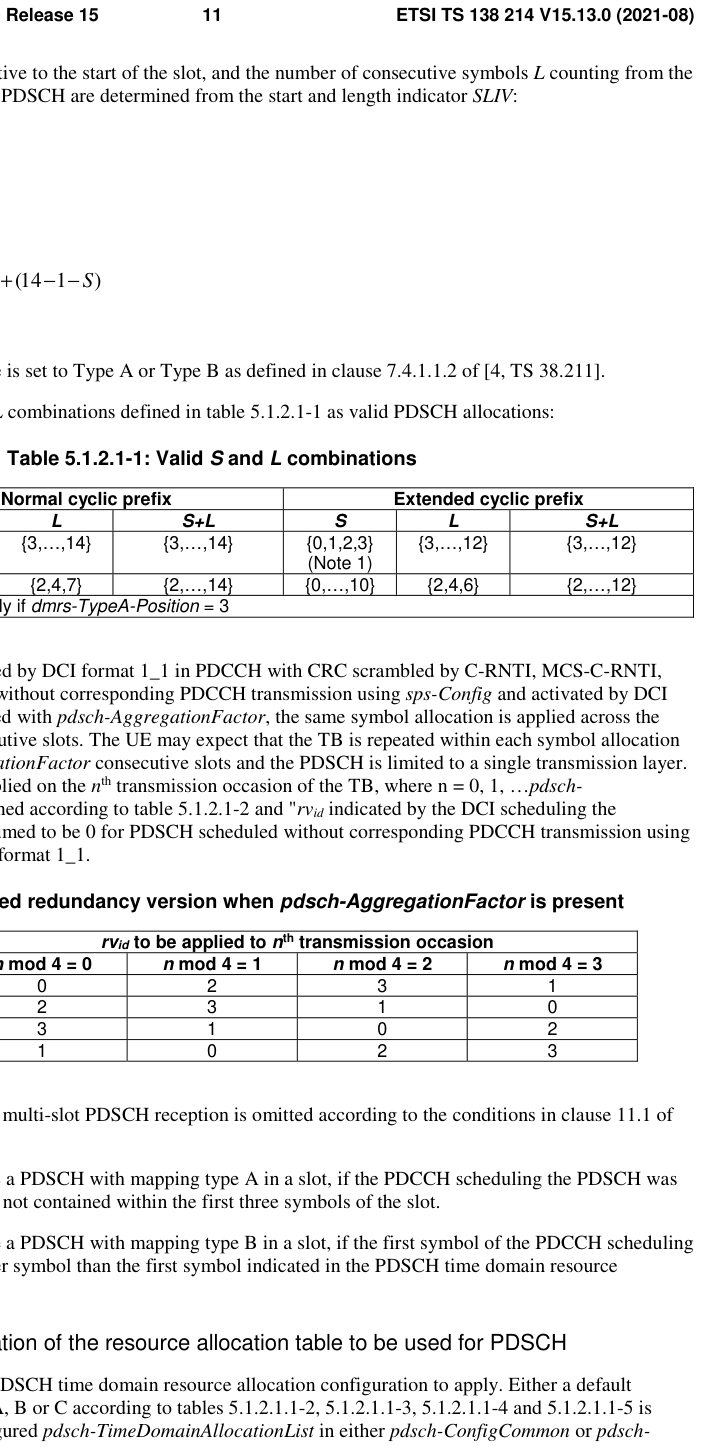
38214_5.1.2.1.1-45.pngSLIV具体计算过程在38214-5.1.2.1中介绍,通过TimeDomainAllocationList获取时域信息参数组,结合SLIV的计算公式和有效的SLIV的约束表38_214_5_1_2_1-1,可以计算出起始符号和长度分别是多少。
38_214_5_1_2_1-1.png

例如:上图中SLIV是54,其中映射类型是typeA,使用normal cp在,遍历可以计算得到S=1,L=12。
SLIV对应的SL表格,可通过如下链接查看获取5G-SLIV.

2.2 什么时候使用DCI或者RRC配置获取时域pdsch信息

PDSCH的时域资源是根据DCI format 1_0/ DCI format 1_1中Time domain resource assignment字段进行确定。其中Time domain resource assignment的bits数取决于RNTI、PDCCH搜索空间以及高层是否在IE pdsch-ConfigCommon或pdsch-Config中配置pdsch-TimeDomainAllocationList相关;如果pdsch-ConfigCommon或pdsch-Config中配置了pdsch-TimeDomainAllocationList,则UE采用pdsch-TimeDomainAllocationList进行时域资源的确定,否则UE根据RNTI、PDCCH搜索空间等信息采用默认的时域资源表进行查表也就是38214中表5.1.2.1.1-2/3/4/5。通过字段Time domain resource assignment的值m用于确定时域资源分配表中的行索引m+1。
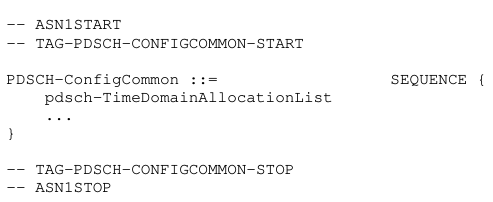
pdsch_common.png

pdsch-ConfigCommon中的配置适用于c-rnti或者cs-rnti加扰的pdcch,不适用于38214表5.1.2.1.1-1中默认值的coreset#0;
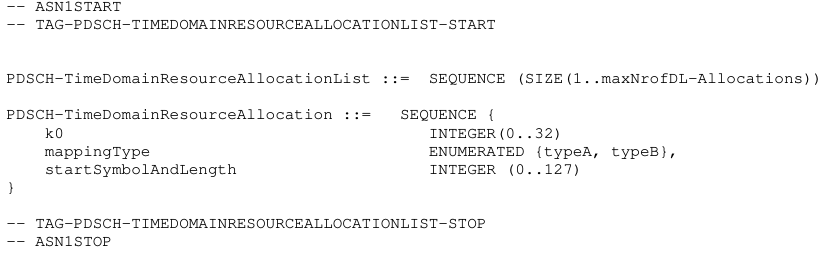
pdsch-TimeDomainAllocationList.png

  • 如果pdsch-TimeDomainAllocationList被配置,那么DCI中Time domain resource assignment的字段宽度就由他确定,DCI中value 0,对应pdsch-TimeDomainAllocationList中的第一个元素,value 2对应第二个,一次类推,其中maxNrofDL-Allocations为16,也就是Time domain resource assignment最大是4bit。

  • 如果pdsch-TimeDomainAllocationList没有被配置,那么Time domain resource assignment的bit数由38214表5.1.2.1.1-2/3/4/5确认,默认是4bit。

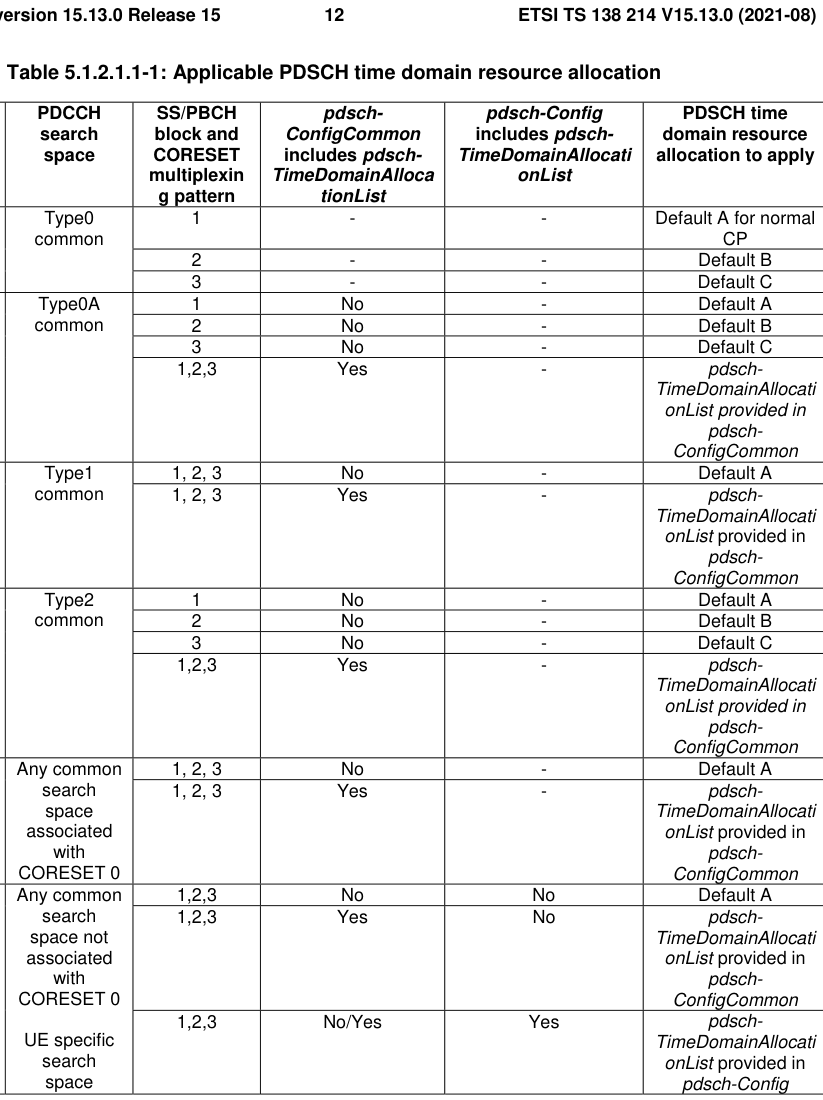
例1:如果UE在PDCCH的Type0A common搜索空间中搜到了由SI-RNTI加扰的PDCCH,S/PBCH block and CORESET multiplexing pattern 是2,那么查表38214-5.1.2.1.1-1,如下,可以得到需要查default B的表,也就是
表38214-5.1.2.1.1-4,根据DCI的Time domain resource assignment确定Row Index,然后找到对应的PDSCH时域资源信息。
38214-5.1.2.1.1-1.png

例2:如果UE在UE specific 搜索空间中搜到了由C-RNTI加扰的PDCCH,其中pdsch-ConfigCommon 包含 pdsch-TimeDomainAllocationList,pdsch-Config中包含了 pdsch-TimeDomainAllocationList,那么pdsch-Config中的pdsch-TimeDomainAllocationList的配置将覆盖pdsch-ConfigCommon中的。从表38214-5.1.2.1.1-1中可以得知,DCI中Time domain resource assignment字段值指示的是pdsch-Config中的pdsch-TimeDomainAllocationList的索引,从而得到PDSCH时域资源{k0,mapping type, sliv}信息对,通过其中SLIV通过上述的反推方式可以计算出psdch的起始符号和符号长度。

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. mcs的选择和码率的确定

对月PDSCH的调度,主要有两种方式的一种是有PDCCH并通过C-RNTI, MCS-C- RNTI, TC-RNTI, CS-RNTI, SI-RNTI, RA-RNTI, 或者 P-RNTI加扰,下发DCI_1_0或者DCI_1_1来调度;另一种是在没有PDCCH的情况下通过高层提供的SPS-Config配置来进行PDSCH调度。
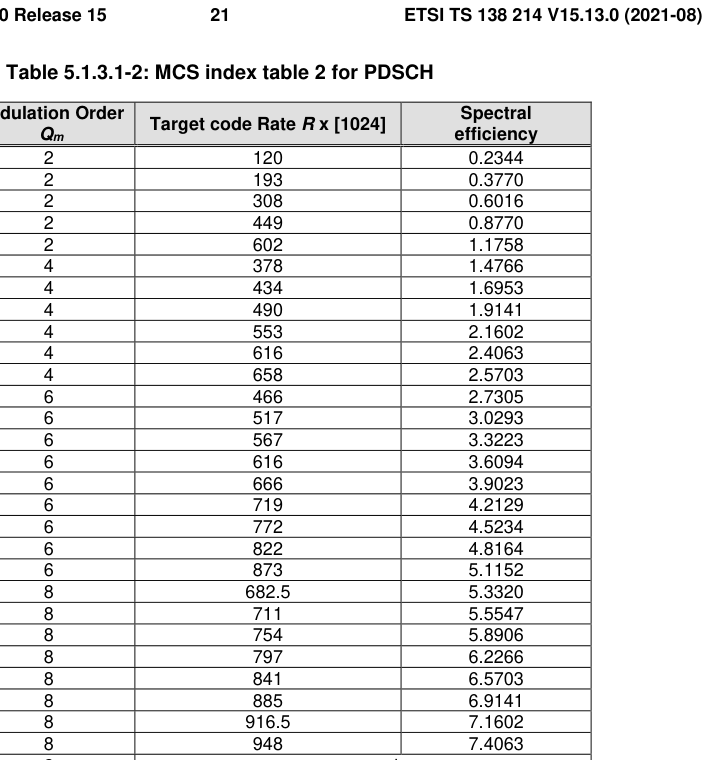
PDSCH调制阶数通过DCI中5bit的字段I_MCS来指数,5bit最大32,协议中定义了3张mcs表,分别是1个256QAM,2个64QAM的表;在不同的场景选用不同的mcs表。比如UE不希望在解码P-RNTI, RA-RNTI, SI-RNTI加扰的PDSCH时,使用Qm > 2的调制方式。

case1: 高层配置PDSCH-config种使用qam256的mcs表,那么对DCI1_1指示的PDSCH使用Table 5.1.3.1-2来确定MCS和码率,也就是256qam的表格。

case2: 如果UE没有通过SPS-config来配置mcs表,而是通过pdsch-config配置了成qam256,那么UE使用Table 5.1.3.1-2来确定MCS和码率,也就是256qam的表格。
pdsch_mcsTable2

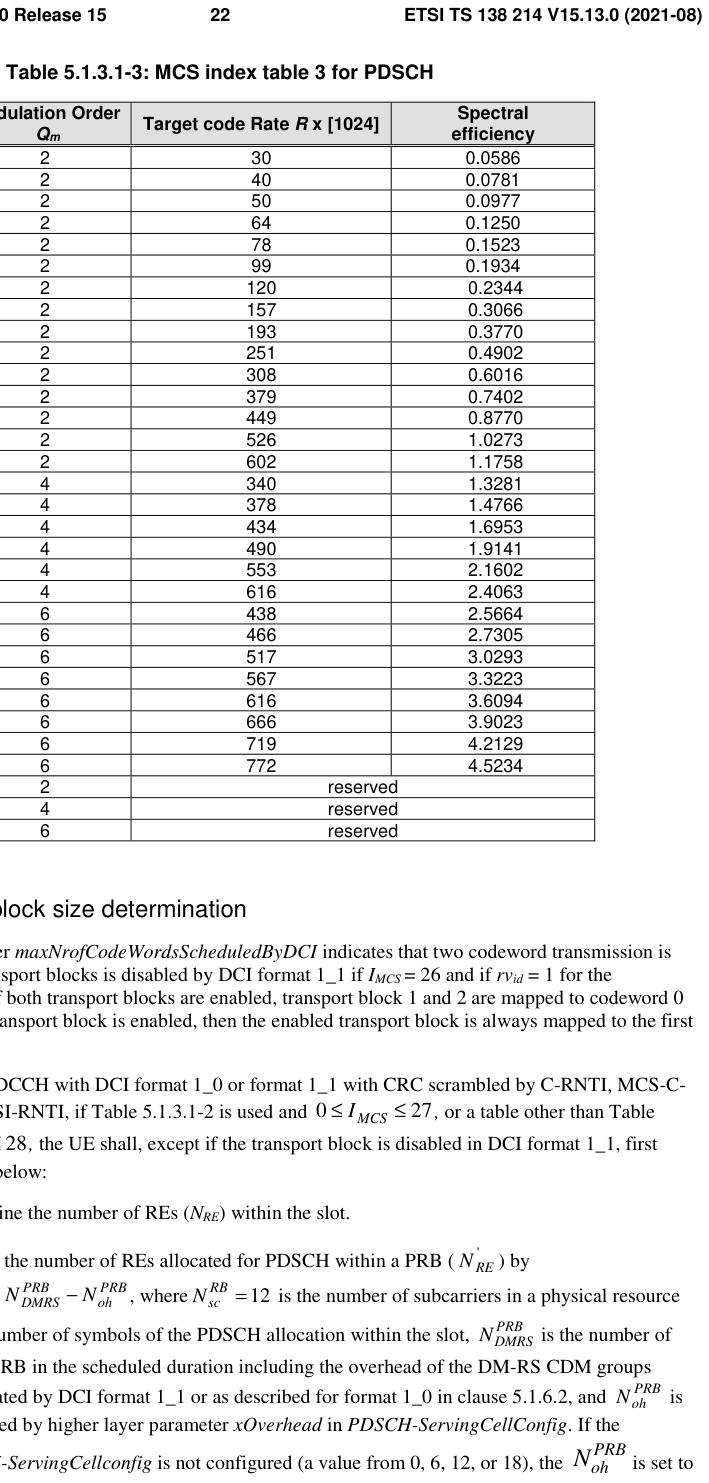
case3: 如果UE没有配置MCS-C-RNTI,且高曾参数pdsch-config种配置的mcs表是qam64LowSE,那么针对UE USS 搜索空间的对应的PDSCH调度使用Table 5.1.3.1-3来确定MCS和码率,也就是低码率的64qam的表格。

case4: 如果UE配置了MCS-C-RNTI,pdsch是被MCS-C-RNTI加扰的PDCCH指示调度,那么UE使用Table 5.1.3.1-3来确定MCS和码率;

case5: 如果UE的mcs表通过SPS-Config配置并且配置成qam64LowSE,那么UE使用Table 5.1.3.1-3来确定MCS和码率;
pdsch_mcsTable3

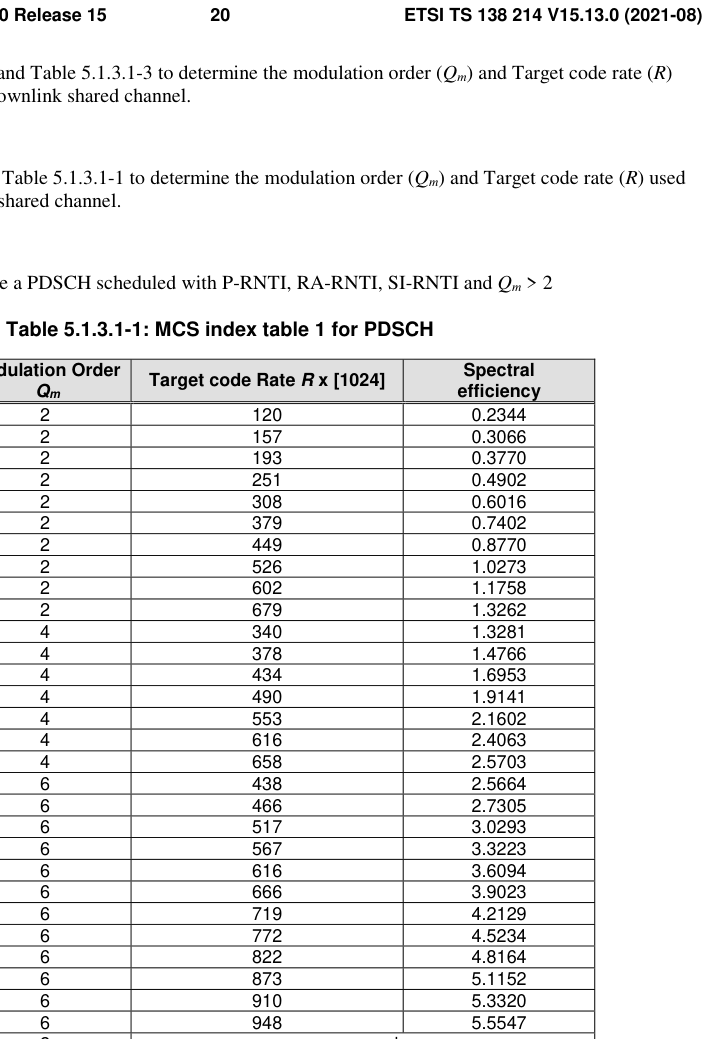
case6:除了上述5种情况外,使用Table 5.1.3.1-1
pdsch_mcsTable1从上述的mcs表种可以看出,当mcs确定之后相应的传输码率就确定了。因此码率是通过mcs查表间接确认得到的。
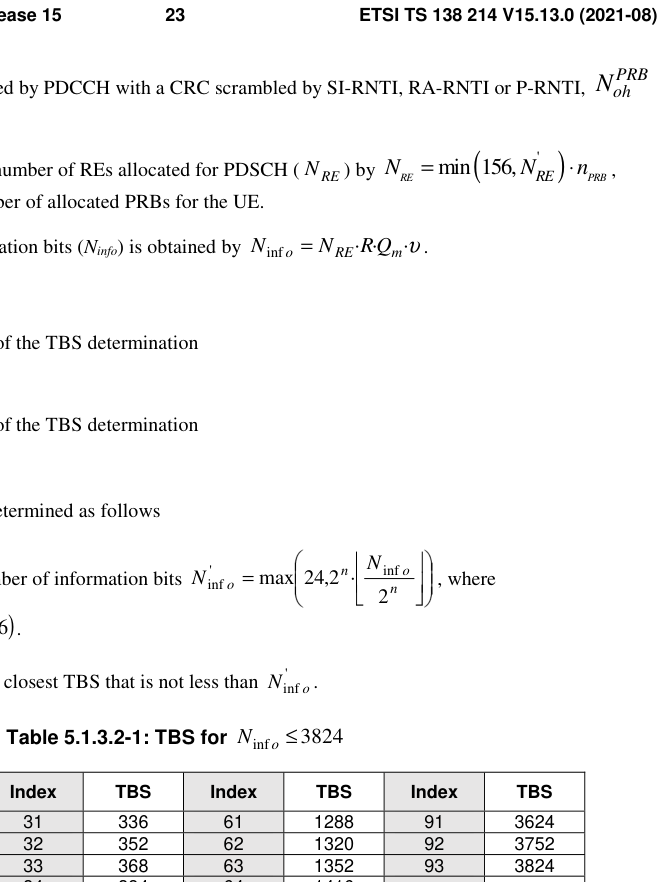
2. TBsize的计算和RB预估

pdsch传输的tbsize宏观上见与码字数和码率强相关,码字由基站高层参数maxNrofCodeWordsScheduledByDCI指示,表示使用1个码字还是两个码字;码率由上mcs表确定,针对64qam可以使用mcs 0-28;256qam可以使用0-27;

2.1 TBsize的计算

一个slot对应的PDSCH可用的TBSIZE计算公式如下,在PDSCH可用的RE是上除去DMRS占用和PDCCH占用的RE等资源占用以后的频谱资源。一个slot种pdsch的有效RE数由如下公式获得:

其中:N ^{RB}_{sc}是一个RB的子载波个数,N^{sh}_{symb}是时域上一个slot对应的符号数,N^{PRB}_{DMRS}是一个RB上DMRS占用的RE数;N^{PRB}_{oh}在高层参数PDSCH-ServingCellConfig->xOverhead配置,可配置为0,6,12,18;当xOverhead没有配置或者调度pdsch的pdcch由SI-RNTI, RA-RNTI 或者 P-RNTI加扰时,N^{PRB}_{oh}是0。
一个slot内频域上所有的pdsch可用RE,由以下公式获取:
$$
\begin{equation}
N_{RE} = min(156, N^{‘}*{RE})n{prb}
\end{eqnarray}
$$
其中,n_{prb}是slot内可分配的PRB数。

有了RE数解可以计算当前的TB-Size了,TB-Size的计算如下:

$$
\begin{equation}
N_{info} = N_{RE}RQ_{m}*v
\end{eqnarray}
$$
其中,R是目标码率,Qm是调制阶数,V标识layer数。

有了N_info之后还需要跟3824作量化比较才能确认最终的tbsize:

  • N_info <= 3824 : 在N_info的小于3824的场景下确定TB-Size需要先量化,然后再查表确认TB-Size;量化公式如下:

$$
\begin{equation}
N^{‘}*{info} = max(24, 2^{n}⌊\frac{N{info}}{2^n} ⌋),其中 n = max(3, ⌊ log_2(N_{info})⌋-6)
\end{eqnarray}
$$
通过量化公式获得的N_'_info在Table 5.1.3.2-1中查找不小于他的最接近的值,比如算出来的量化值是606,那么通过查表就获得的TB-Size就是608;
tbs_low_3824

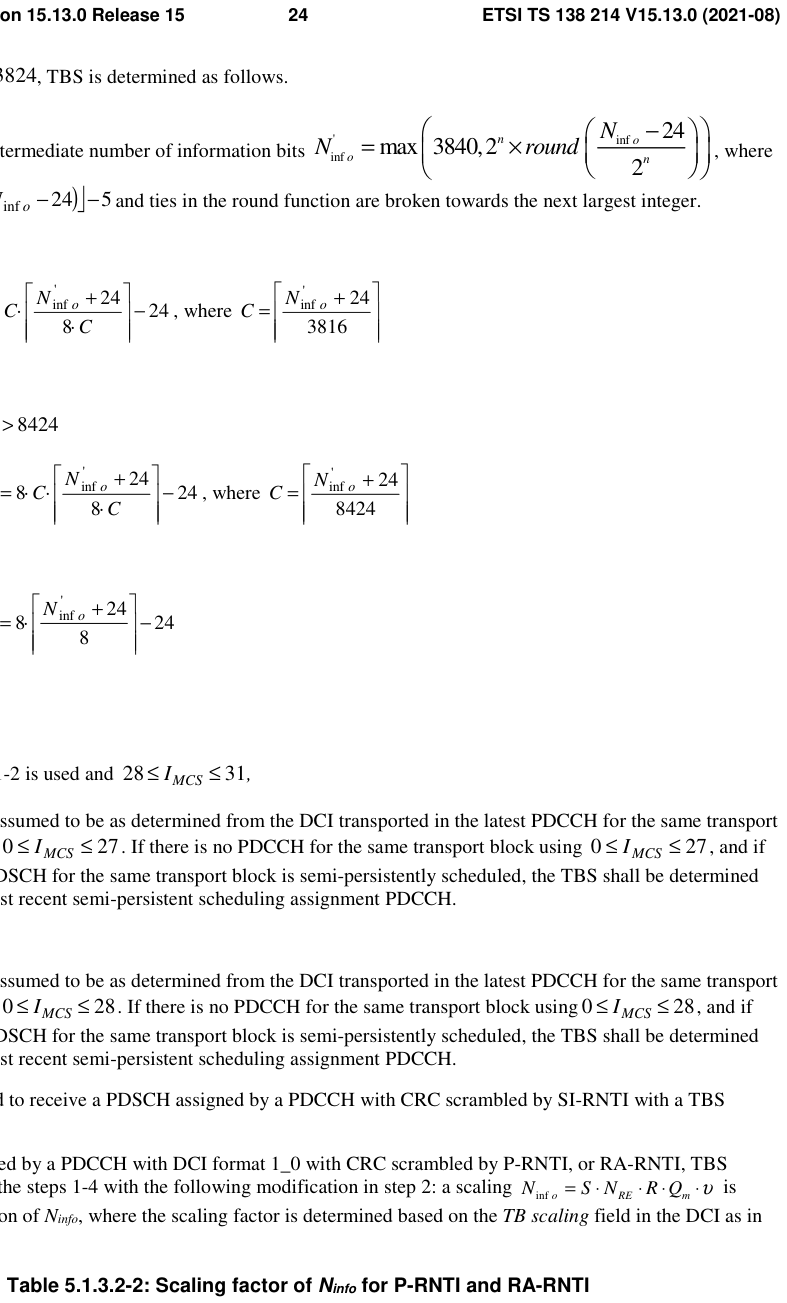
  • N_info > 3824 :

$$
\begin{equation}
N^{‘}*{info} = max(3840, 2^{n}round(\frac{N{info}-24}{2^n} )),其中 n = ⌊ log_2(N_{info}-24)⌋-5)
\end{eqnarray}
$$

当码率R<=1/4时
$$
\begin{equation}
TBS = 8C ⌈(\frac{N^{‘}{info}+24}{8C})⌉-24,其中C=⌈\frac{N^{‘}*{info}+24}{8424}⌉
\end{eqnarray}
$$

当码率R>1/4时
(1) 如果N_'_info>8424, 那么TBS通过以下公式计算:
$$
\begin{equation}
TBS = 8C (\frac{N^{‘}{info}+24}{8C})⌉-24,其中C=⌈\frac{N^{‘}{info}+24}{3816}⌉
\end{eqnarray}
$$
(2) 如果N_'_info<=8424, 那么TBS通过以下公式计算:
$$
\begin{equation}
TBS = 8
C* (\frac{N^{‘}{info}+24}{8})-24
\end{eqnarray}
$$
需要注意的是:**(1)** 当调度PDSCH的PDCCH是通过SI-RNTI加扰的话,也就是传输sib1消息时,TB-Size的大小不能超过2976,因为sib1只能通过qpsk的调制方式发送;**(2)** 当调度的DCI是P-RNTI、RA-RNTI加扰的时候,在信息量N_info计算时需要带上一个缩放因子,具体如下图所示:
tbs_Scaling_factor
那么新的N_info计算公式就编程如下的样子:
$$
\begin{equation}
N
{info} = S*N_{RE}RQ_{m}*v, 其中S是缩放因子
$$

2.2 RB预估

UE进行上下行数传的时候,基站根据UE的数据量来判断UE的调度时刻使用的RB数,数据量的计算公式如下:
`$$
\begin{equation}
数据量 = {N_{prb}N_{re}layerQmCodeRate},
$$
N_prb是传递这些数据量需要的RB数,N_re是每个RB中有效的RE数,layer是数传的UE的rank,QM是调试bit数,CodeRate是传输的码率。

预估RB就是通过上边的公式反算UE传输当前数据量需要的RB数,在确定RB数之前需要先确定,每个RB中的RE数,这些RE数跟基站的配置相关,特别是PDCCH和PDSCH DMRS的配置。

PDSCH DMRS : NR中定义了两种DMRS type,分别是type1和type2,在这两种type中,有1符号或者2符号的DMRS,除此之外还可以配置额外的附加导频的DMRS。

pdsch_pusch_type

-
PDSCH DMRS Type A :固定在第三或(pos2)者第四(pos3)个符号上,无论PDSCH的起始符号是多少,最小资源组是一个RE;

-
PDSCH DMRS Type B :DMRS固定在分配PDSCH的第一个符号上;最小资源组是2个RE;

  • 附加导频 ,可以配置0-4个

【参考文献】:https://www.sharetechnote.com/html/5G/5G_PDSCH_DMRS.html

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

BSR是一种从UE到网络的MAC CE;它承载有关UE缓冲区中有多少数据要发送出去的信息,用来申请上行带调度资源通知基站需要多少资源;

1. BSR的配置和内容

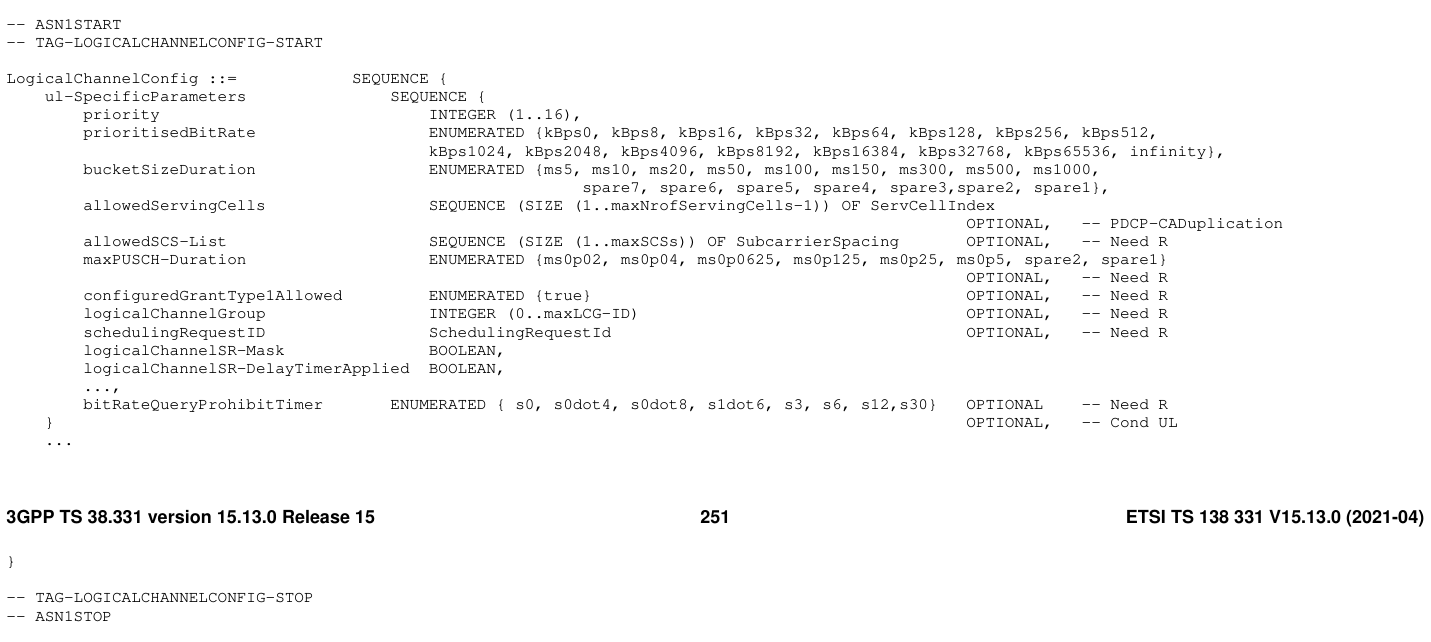
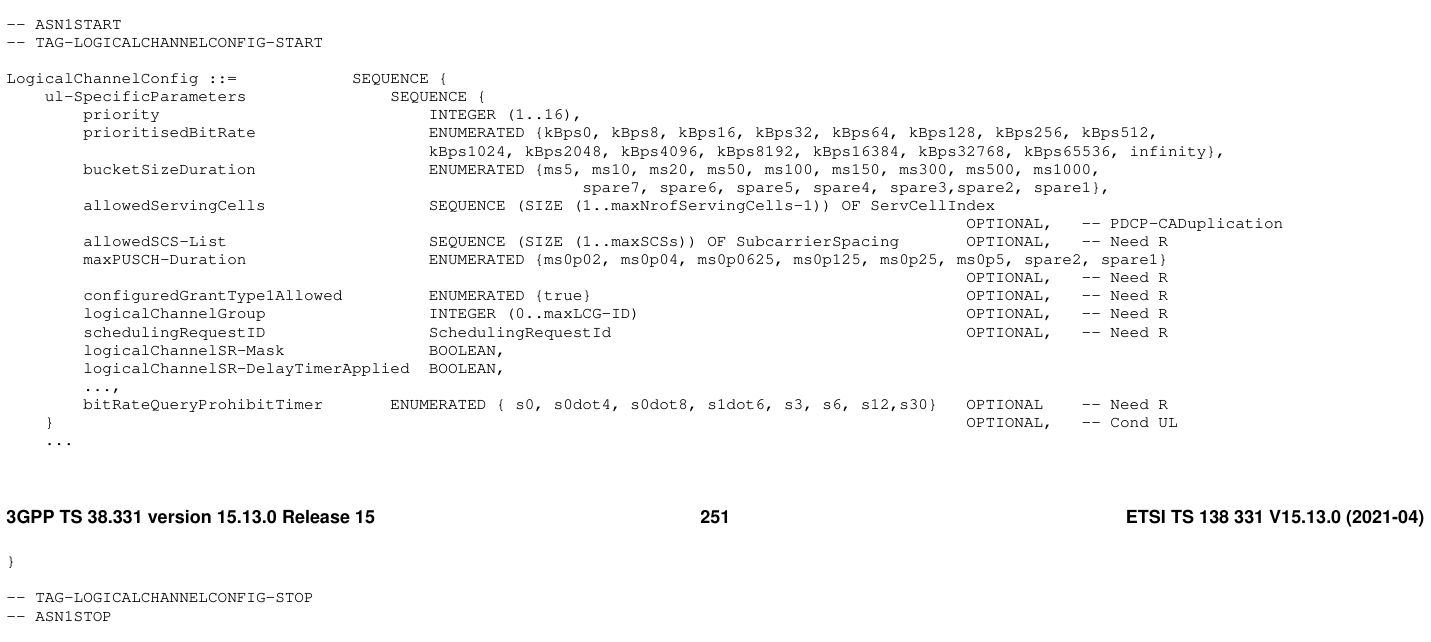
UE可以建立多个无线承载,每个承载对应一个逻辑信道,如果每个逻辑信道都上报一个BSR,会产生大量的开销,基于这种考虑就引入了逻辑信道组的概念LCG,将逻辑信道放到逻辑信道组中,UE基于LCG来上报BSR,而不是为每个逻辑信道上报BSR,这样把相似的逻辑信道放到一个LCG中,优化了BSR上报的机制。如何划分LCG是基站根基算法实现,这里不讨论。逻辑信道的配置在LogicalChannelConfig->logicalChannelGroup中配置。

LogicalChannelConfig

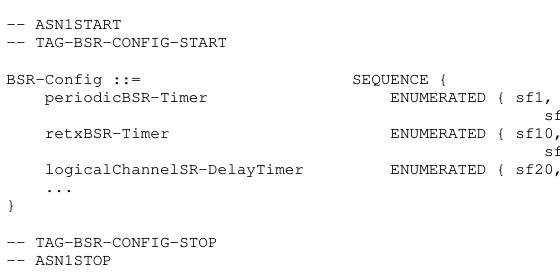
在logicalChannelConfig中的参数logicalChannelSR-Mask需要注意一下,这个参数仅针对常规BSR有效,当UE触发一个常规BSR,且已经配置了上行授权同时该逻辑信道的logicalChannelSR-Mask为true,那么就不需要发送SR。如果logicalChannelSR-Mask为false,则需要发送SR;对应到每个MAC实体的bsr-config如下图所示:

bsr-config从配置中可以看到BSR-Config有几个定时器相关的参数,分别是:

  • [1] retxBSR定时器,重传定时器是为了避免UE一直发BSR而得不到UL Grant的情况;

  • [2] periodicBSR定时器,周期性检查UE的BSR,避免由于其他条件不满足导致UE的BSR得不到调度的情况;

  • [3] logicalChannelSR-DelayTimer,表示在logicalChannelSR-DelayTimerApplied的启用的逻辑信道的SR传输延时定时器;如果逻辑信道配置了logicalChannelSR-DelayTimerApplied,在触发常规BSR时,会启动或者重启logicalChannelSR-DelayTimer;如果没有配置logicalChannelSR-DelayTimerApplied,在没有上行调度资源来传输新传数据时会触发SR;

BSR通过MAC层的MAC CE上报,NR定义了有4种类型的BSR MAC CE,分别是: 短BSR/短截断BSR,长BSR/长截断BSR。一个BSR MAC CE与一个对应一个MAC subheader,也就是对应的LCID值,对应关系如下表所示:

bsr-lcid需要注意的是LCID和LCG不是一个概念,LCID是MAC PDU对应的逻辑信道号。
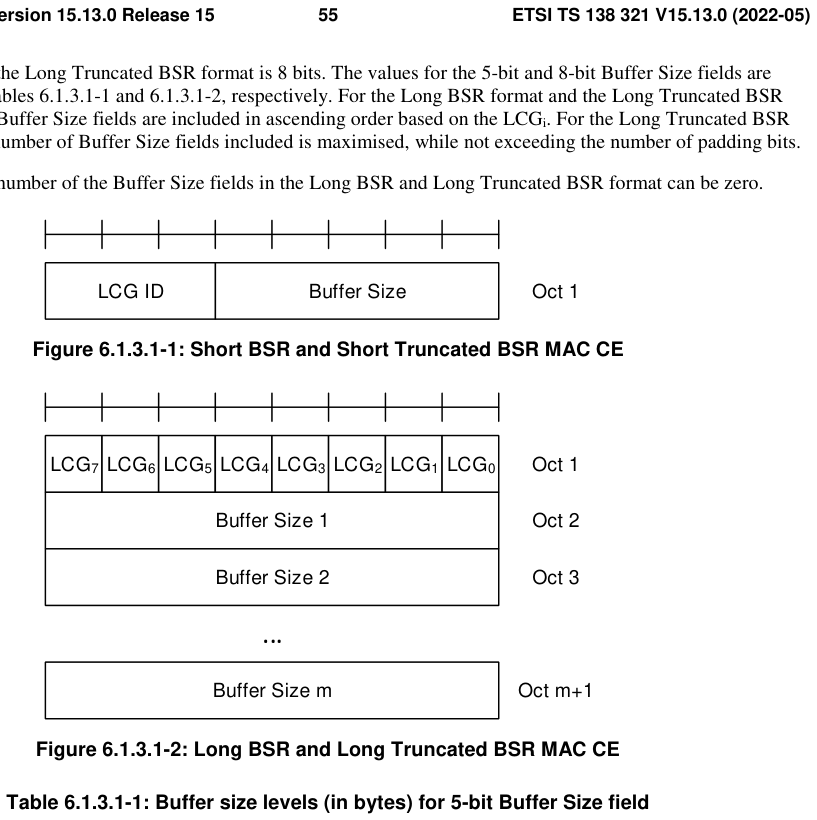
短BSR和短截断BSR,只上报一个LCG的BSR,长度固定为8bit,并有一个长度为3bit的LCG ID字段和一个长度为5bit的buffer Size字段组成。如下图所示:

pusch_bsr长BSR/长截断BSR可以上报一个或者多个LCG的BSR,长度不固定,如下图所示,LCG ID有3bit的字段,最多可以上报8个LCG,其值对应LogicalChannelConfig->logicalChannelGroup;图中的LCG序号标识对应编号的逻辑信道是否存在buffer size,如果改字段设置为1,则表明该编号对应的逻辑信道有BSR;否则没有;其中buffer size,长度8bit,是LCG所有逻辑信道的RLC和PDCP中剩余的可用于上行的有效传输数据综合,以byte为单位,不计算RLC和MAC的数据头。
pusch_bsr长/短BSR的buffersize分别是8bit5bit,那么他们要给基站的参考数据量有下标定义给出一个大概的范围,表中的buffer size value作为基站分配合适上行资源的参考,并不表示一定能给UE分出来这么多。
pusch_bsrpusch_bsrpusch_bsr

2. BSR分类

协议中定义了三种类型的BSR:分别是Regular BSR,Periodic BSR和Padding BSR。三种BSR场景下适配长短BSR关系主要根据要发的LCG数量和响应的传输bit决定,对应关系如下图所示:

pusch_bsr

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. SR(Scheduling Request)

SR是UE的调度请求,用在UE像基站申请上行数据的新传调度,通过PUCCH传输,有些格式的PUCCH格式可以携带SR有些则不行。不是每次都能不一定能申请到PUCCH资源,只有UE处于RRC Connected状态且保持上行同步的UE才会发送SR;
SR

2. SR的配置

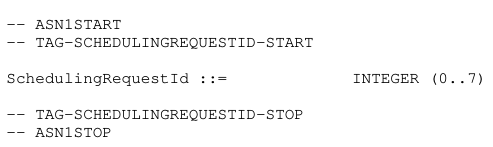
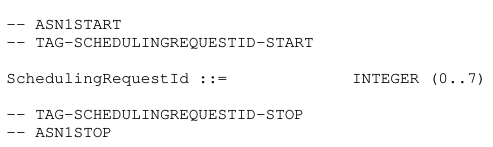
在基站中SR的配置在SchedulingRequestResourceId IE中定义了SR资源的数量,最大8个SR资源,对应的SchedulingRequestResourceId就是0-7 ;
SchedulingRequestId
MAC的配置中, 逻辑信道可以分别关联SR配置,一个MAC实体可以配置0个、1个或者多个SR配置,不同的逻辑信道可以关联相同的schedulingRequestID,如果没有给相应的逻辑信道配置SR,当该逻辑信道有数据发送时只能通过随机接入获得上行调度。
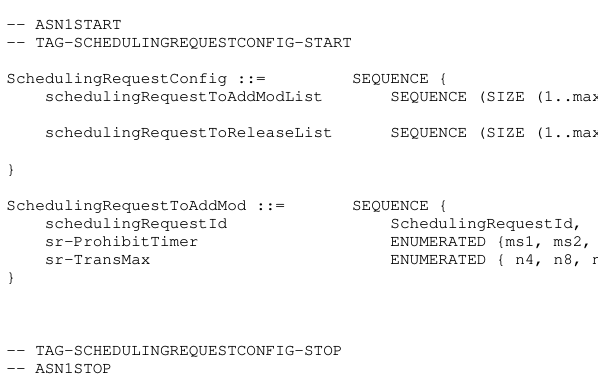
一个mac实体通过MAC-CellGroupConfig->schedulingRequestConfig->schedulingRequestToAddModList配置一个SR列表。其中每个SR配置对应一个schedulingRequestConfig;
SchedulingRequestConfig

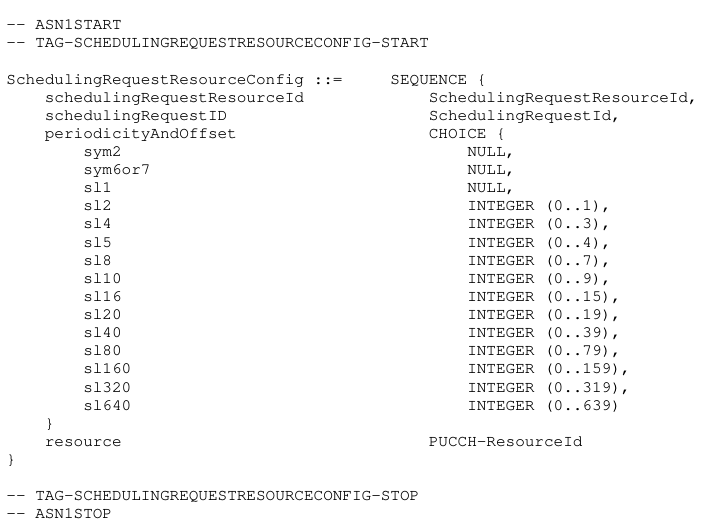
一个SR配置(SchedulingRequestConfig)包含了分布在不同bwp或者小区中用于传输SR的一组PUCCH资源,也就是SR资源,目前SR只支持PUCCH format0或者PUCCH format1. 从协议38.331的描述可以看到一个SchedulingRequestConfig中对应一组SchedulingRequestResourceConfig,也就是一个SR配置可以对应多个SR资源,他们实际使用是分布在不同的小区或者BWP上。在特定逻辑信道上,每个BWP最多配置1个用于SR的PUCCH资源。

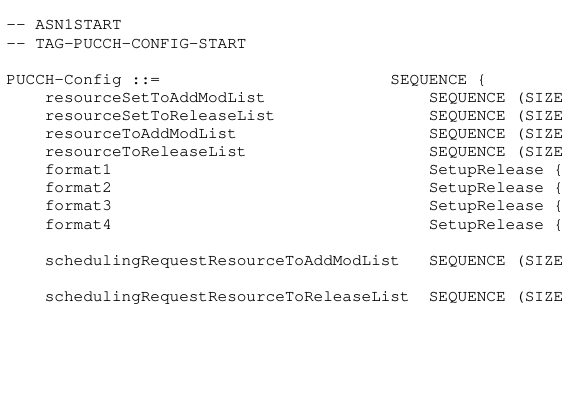
上行BWP通过BWP-UplinkDedicated->pucch-Config->schedulingRequestResourceToAddModList配置一个SR资源表,每个SR资源对应一个SchedulingRequestResourceConfig,这个SR资源有一个schedulingRequestID指示它被哪个SR配置使用,schedulingRequestID 是区分不同的SR配置的唯一值,关联了sr-ProhibitTimersr-TransMax。通过BWP与小区的对应关系,可以确定一个SR配置在特定小区的特定上行BWP上使用的SR资源。

在pucch-config中为各个上行bwp配置了sr资源使用schedulingRequestResourceId来区分不同的资源配置,schedulingRequestResourceId会关联schedulingRequestID,还包括SR发送时间点配置,以及对应的pucch resource配置。
SchedulingRequestResourceId

下图是SR在接入过程的对逻辑信道的配置的示例,信令中对SRB1/SRB2/DRB都配置了响应的相同的SR资源。

SchedulingRequestId

3. SR的发送

针对每个SR资源,基站通过SchedulingRequestResourceConfig->resource告诉UE使用PUCCH format0还是 format1来发送SR。
SchedulingRequestConfig
SchedulingRequestId

在SchedulingRequestResourceConfig中的periodicityAndOffSet字段指定传送SR的PUCCH资源的周期,以符号或者slot为单位,确定了SR的发送时间位置[TS38.331 9.2.4]。可以看到SR的最小周期是2符号。
基于SR周期的差异,把SR对应三种场景来,如下图case所示:
SchedulingRequestId

从协议指示的配置范围可以看出,根据不同的子载波间隔,可选择的周期偏移有所不同;当UE发现一个SR传输机会对应PUCCH资源所在的slot,用于改pucch传输的符号数小于对应pucch资源所需的符号数,UE不会在该slot上发送pucch资源;
SR资源是UE专用,UE发送SR时不需要指定自己的CRNTI,基站通过SR资源的时域、频域和码分复用信息就知道哪个UE请求上行资源。
SchedulingRequestId

协议描述中有Positive SRNegative SR的概念,UE并不是一直有发送SR请求的需求,对于Positive SR即UE有SR请求发送,需要物理层发送SR/PUCCH,而对于无SR发送请求的UE,在SR资源的时间点,则该SR为Negative SR。基站不知道UE什么时候发送SR,需要在已经分配的SR资源上检测是否有SR上报,会在每个SR上来的时刻监测是否有SR资源,具体的SR调度流程如下图所示:
SR调度流程
SR调度流程注意事项:

  • 只有在pucch资源上配置了SR才能发送SR请求上行调度,不然只能通过随机接入申请上行资源;

  • SR发送实际在PUCCH的特定位置,以便基站能检测到SR;

  • SR发送实际不能和测量GAP重合;

  • 如果sr-ProhibitTimer未超时,则不能发送SR,此时定时器放置SR发送过多,降低PUCCH负载;

  • 当UEUESR的传输实际和测量gap重叠或者sr-ProhibitTimer未超时等原因不能发送SR时,需要循环检测,指导条件满足;

  • SR-COUNTER为计数器,只有当SR-COUNTER<sr-TransMax时,才能发送。为了放置SR重传发送过多,当SR成功触发UL GRANT后,SR-COUNTER会置零;

  • UE触发SR后,这个SR级处于pending态,意思是为UE准备单是还没有发送SR,如果已经准备发送BSR,或者PUSCH资源足够,那么pending的SR会被取消。

UE发送SR之后,无法确定基站什么时候会下发UL Grant,如果UE等待超时(由果sr-ProhibitTimer定时器配置)就会尝试重发SR,每个SR都有自己的果sr-ProhibitTimer
当SR请求发送达到最大次数仍然不能获得上行调度后,通过发送PRACH触发随机接入过程来获得上行调;当SR的到达最大发送次数后无上行调度,除了发送PRACH外,MAC执行的操作还包括:

  • 1.通知RRC Release所有服务小区PUCCH配置;

  • 2.通知RRC Release所有服务小区SRS配置;

  • 3.清除Configured DL assignments和 Configured UL Grants.

  • 4.清除用于发送semi-persistent CSI的PUSCH Resource.

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. 背景

5G频谱在全球各国进行的划分,以主力中低频段主力,中频段主要是TDD,低频段与原有的LTE频谱共用。图1-1是目前主要国家的频谱划分。

image图1-1 全球主要国家的5G频谱

频段的分配上,TDD是5G部署的主流,特别是亚太的中日韩地区;在5G部署的初期,TDD制式的主流的设备基本部署在以3.5G为主的频段上,没有历史的遗留问题要解决;但是并不是所有的国家或者运营商都有这样的频谱;在欧美地区,中频段的频谱已经被部分占用,比如北美3.5G频谱被军用卫星占用;除此之外,3.5G的覆盖也是相对差一些,如何提升覆盖,让用户5G的信号服务更广泛的用户,是当前运营商面对的主要问题之一。频谱的价格也比较昂贵,如何复用低频段的已有频谱频谱,快速部署5G,同样也是运营商面对的主要问题。
针对上述两个问题,3gpp提供了两种解决方案方法:(1)把5G部署到低频段里面与LTE共存;(2)让低频段辅助3.5G进行业务。基于运营商的困难和现实的瓶颈,各设备厂商提出了两个解决思路:(1)辅助上下行(SUL/SDL);(2)LTE和NR共存。辅助上下行,不是这里讨论的内容;当前只关注LTE和NR共存的问题

2. LTE和NR的动态频谱共享

动态频谱共享,从名字上看,在一块特定频谱上,LTE和NR在时域或者频域上同时存在,都有业务,资源复用。就是在时域和频域上划分,概括为FDM(频分)和TDM(时分)。如下图2-1所示。

image图2-1 TDM和FDM共享示意图

  • FDM:(1)静态分割为独立载波,频带上无LTE使用的资源;(2)在保证LTE正常的业务的情况下,将LTE原本使用频域资源的频域资源进行划分,分给NR使用;

  • TDM:(1)分时按子帧级别共享复用,在保证LTE正常业务的情况下,将某个子帧中除了LTE使用的控制信息使用的符号外,都分给NR使用。主要分为MBSFN和non-MBSFN两种情况。

具体到LTE和NR的业务实际,该如何实现共享呢?LTE的调度最小粒度是subframe,NR的最小粒度是slot。在subframe范围内,考虑LTE和NR的共享和共存,如图2-2的所示,主要是细分为四种场景:

  • (1)在某个subframe NR使用LTE没用的频谱;

  • (2)在某个subframe LTE都不使用,全部由NR使用频谱;

  • (3)在LTE的MBSFN子帧中,LTE使用部分符号,剩下的由NR使用;

  • (4)某个subframe LTE PDSCH不调度,NR使用个别符号调度。

image

图2-2 LTE和NR共存是频谱共享的方式

3. 实现LTE和NR共存的方法

根据运营商的实际需求和实现的系统复杂度,在3GPP R1‑1701618[1]会议的讨论如表3-1所述的5种方式;前三种Static FDM、Semi-static TDM和subframe级别的DSS(动态频谱共享)三种共享共存的方式是3gpp优先考虑的策略。第一个阶段是Static FDM,然后是Semi-static TDM,接着是subframe级别的DSS。目前这三个阶段宏站的设备厂商基本已经走完。

表3-1 动态频谱共享的实现方法

共享方式 描述
Static FDM 带宽为20 MHz,动态划分LNR使用比例,5 / 15、10 / 10或15/5 MHz分区等
Semi-static TDM 利用LTE DL MBSFN子帧和未使用的UL子帧的资源来调度NR
Subframe 级别DSS 在时域上subframe级别使用LTE未使用的资源
CLI级别DSS 根据CLI mitigation of duplexing flexibility使用LTE未使用资源传输NR
PRB级别DSS 在频域上在时域上子帧级别使用LTE未使用的资源

5G的制式和LTE一样,依然是TDD和FDD二分天下,由于TDD的频谱分配的先天优势,LTE和NR共存的场景和需求很少出现,而FDD因为LTE的历史频谱问题,有大量的存量网络,在网络从LTE到5G的升级换代的过程中,迫切的需要LTE和NR的频谱共享,制式共存。实现这种共享共存的技术,称为动态频谱共享,简称DSS。
image image image

图3-1 LTE和NR FDM和TDM RE级别的频谱共享示意图
根据运营商的频谱和现网的测试情况,我们看到四大主设备厂商对LTE和NR的频谱共享各有侧重,在表3-2中简要列出。

3.1 主流设备厂商的频谱共享方案

表3-2 四大设备厂商的动态频谱共享场景

厂商 解决方案 TDD/FDD制式 备注
华为 Hybrid DSS TDD和FDD TDD主要考虑中移动
爱立信 Ericsson SS FDD
爱立信 Super DSS TDD和FDD TDD主要考虑中移动
诺基亚 DSS FDD

从他们针对的运行商和测试结果来看,华为和中兴的TDD方案主要针对中移动N41获得的160M 2.6G频谱的解决大带宽部署LTE和NR共存的问题。诺基亚和爱立信在FDD上的耕耘,更富热情,大量存量的low band频段是FDD的LTE网络,在进入当前网络部署的阶段,如何快速的部署5G,与LTE共存,对他们的欧洲和北美客户来说是一个需要解决的现实问题。面对客户的痛点,他们通过动态频谱共享技术, 帮助客户进行提升网络部署,拓展业务。在FDD和TDD上,他们的方案有什么具体的差异,又是如何设计解决方案的呢? 在接下的部分,将分别介绍四大设备厂商动态频谱共享在TDD和FDD的实现技术方案,其中TDD介绍介绍华为中兴的方案;FDD介绍爱立信和诺基亚的方案。

3.2 动态频谱共享IN TDD

动态频谱共享在TDD的实现,华为和中心的方案基本差不多,在支持mimo的AAU上保证4G不移频的情况下,主要部署2.6G NR。如图3-2所示,是中兴的频谱共享方案和2.6G的演进变化。主要是预期三个阶段:

image

图3-2 中兴在中移动2.6G上的动态频谱共享解决方案

  • 阶段1:在不使用LTE和NR动态频谱共享之前的,LTE大面积在网部署的时候,在2515-2575范围内,固定部署60M的NR,剩下的100M都部署LTE的载波。

  • 阶段2:当5G进入中期部署,NR已经规模部署,还存量大量的LTE网络,在2575-2595范围的40M,根据LTE和NR的负载情况,动态部署NR和LTE的载波,进行动态频谱共享,在40M的载波中动态的建0或1或2个20M的载波。

  • 阶段3:当NR进入连片组网,LTE网络开始进入中后期,存量下降,将频谱共享的频段完全固定作为NR带宽,保证满带宽100M的,进行整体连片100M NR的建网。

华为的方案是什么样的呢?如图3-3所示,根据LTE和NR的负载情况,动态的决定频谱属于哪种制式使用,这种迁移相当于静态的频谱划分,属于静态FDM的范畴。也是2个20M的带宽,为什么是20M呢?因为LTE最大支持的载波就是20M。跟中兴的方案,总体上差别不大。

image

图3-3 华为在中移动2.6G上的动态频谱共享解决方案

3.3 动态频谱共享IN FDD

在FDD的网络中,爱立信和诺基亚存量的份额比较高,相对华为和中兴,有市场的优势。在存量LTE和新部署NR的融合过程中,如何利用好低频的FDD网络快速部署NR,爱立信和诺基亚更积极一些。这里主要讲一下他们的动态频谱共享方案。图3-4是他们的频谱共享演进示意图。这里将主要介绍在FDD诺基亚和爱立信实现的协议细节,具体的解决方案将在下个章节进行介绍。

image

图3-4 LTE和NR动态频谱共享的 IN FDD 示意图

FDD上下行频段分开,不存在上下行串扰,很容易利用上行或者下行的载波资源,用来补充NR的业务。例如SUL,利用FDD的上行频段扩展NR的覆盖。在频谱共享的中,如何利用到FDD的上下行资源呢?上行频段基站的行为较少,比较容易控制;下行频段基站的测量信号和信号比较多,在处理时就需要考虑最大化利用LTE或者NR频谱,让LTE和NR高效的融合,例如: SSB,CSIRS,TRS,DMRS,PDCCH等等。接下来将详阐述这些资源在FDD制式中,如何以LTE共享共存。

image

图3-5 LTE和NR共存是NR SSB的放置示意图 in Non-MBSFN

3.3.1 如何放置SSB

NR PDSCH传输的情况下,SSB资源分配与LTE CRS冲突,而且由于帧结构的差异,子载波间隔也可能不同。LTE有MBSFN的子帧,在MBSFN子帧中,除了前两个符号被用于传输控制信号外,其他的符号都可以空出来。那么,在处理NR数据时,就要考虑MBSFN和非BMBSFN。

Non-MBSFN子帧

NR的SSB需要4个连续的符号,不能更改LTE或者NR的SSB结构,唯一的方法就是在找到资源让NR的SSB挤到进去。如图3-5所示SSB在不同case下的可能放置的情况,LTE的CRS使用的RE与天线port数相关,下图示例为1/2/4port场景。
LTE的子载波间隔固定在15KHz,对应NR的3种case。

  • Case 1: NR和LTE都是15kHz,NR连续4个符号的SSB都会与CRS冲突;

  • Case 2:NR 30kHz,占用2符号的LTE是可行的;

  • Case 3:NR 30kHz,在1/2port的LTE是能够放置的,在4port时会与LTE的CRS冲突。
    当LTE和NR的子载波间隔不同的时候15kHz和30kHz,会破坏正交性,不能按常规的并排放置数据,需要加保护间隔,如图3-6所示。保护带宽虽然能避免喜好的冲突,但是无法兼顾所有的case场景,而且还会让带宽利用率减低。因此在Non-MBSFN的不太适合放SSB信号。
    PALCE_SSB9.png

image

图3-6 LTE15kHz和NR 30kHz SSB共存放置的示意图

MBSFN子帧
怎么才能兼顾到多场景的case,还不用考虑LTE由于port数配置的差异导致的?MBSFN子帧,恰到好处!MBSFN子帧不能完全为空。需要定义了一个非MBSFN区域,该区域的长度可以是1-2个OFDM符号。该区域旨在承载用于LTE的控制信道,如PHICH,PCFICH和PDCCH等。NR传输只能在MBSFN子帧内从OFDM符号2或3处开始。在MBSFN子帧中不用考虑CRS的影响。图3-7示意在MBSFN中如何放置NR的SSB,在case 1/2/3的时都可以完美的放下至少1个SSB。

image

图3-7 LTE和NR共存是NR SSB的放置示意图 in MBSFN

LTE中有6个帧可以配置为MBSFN子帧,分别是#1,#2, #3, #6, #7, #8. 为了减少MBSFN对LTE的性能影响,通常只配置1个MBSFN子帧,用sib2进行广播。bypass掉MBSFN subframe中LTE符号的情况下,剩余的符号可以传输 NR SSB, SIBs, CSI-RS, TRS and PDSCH data 等。

image

从对LTE吞吐量的影响来看,基于MBSFN频谱共享,通常不是数据的最佳选择。但是,使用MBSFN子帧对于基于SSB SCS提供SSB传输非常重要,因此是首选的DSS解决方案。

【注意】这里case3 虽然时针对TDD得场景,但是考虑到上下信号得干扰和资源使用率以及客户得需求,TDD下得TDM方式得动态频谱方案暂时没有厂商实现。

3.3.2 如何放PDCCH和PDSCH

与放置SSB信号类似,如何放置PDCCH,也需要考虑MBSFN和Non-MBSFN的情况。在Non-MBSFN的子帧中,频谱上直接同时铺LTE和NR数据,如3-8图所示,NR CORESET与LTE控制信道位置冲突。如果将coreset往后挪来给2个符号只放到符号2上,但是仍然会有NR PDSCH与LTE CRS重叠,与LTE中的控制信道类似,无论PDSCH区域的大小如何,CRS对整个频带上的所有设备都是可见的。无法正常工作。

image

图3-8 NRPDCCH和PDSCH和LTE同 slot共铺数据示意图(1)

如何保证LTE和NR的数据都能在频谱上不冲突的时候的共享编码呢?除了CRS还会有其他的信号干扰到NR的PDSCH嘛?还有SSB。针对SSB和CRS,可以采用,ratematching的方式(图3-10是CRS RateMatching示意图),,将他们所在的RB或者RE打孔掉,不放置NR的PDSCH数据,同时把NR的CORESET / PDCCH配置到位于符号2。这样就能解决PDCCH和PDSCH传输的问题。

image

图3-9 NRPDCCH和PDSCH和LTE同 slot共铺数据示意图(2)

image

图3-10 无LTE-SSB的时候crs ratematching,单符号DMRS,无附加导频

image

图3-11 LTE-SSB和LTE-CRS rate matching的打孔示意图

当PDCCH符号放到了符号2,那么PDSCH的符号必须从符号3开始,由于pdsch dmrs的占用,pdsch在不使用dmrs剩余符号的时候只能从符号4开始,因此无法在pdsch typeA的时候进行频谱共享。需要将pdsch的type类型调整为typeB。图3-12 展示的tapeA和typeB的差异。

image

图3-12 NR PDSCH typeA和typeB的差异 示意图

3.3.3 如何放置PDSCH DMRS

NR pdsch的DMRS导频信号,根据配置的天线数和映射方式有一定的差异,在LTE的 FDD一般都是4port以下,因此这种影响基本可以忽略掉,稍微简单处理,考虑单符号的导频即可,最多3个附加导频信号场景即可。
图3-13是NR PDSCH DMRS单符号,3个附加导频的情况;第3个附加导频在LTE为1/2/4port的时候都会与CRS产生冲突。如何规避掉部分呢?跟PDSCH一样打孔掉嘛?可能行不通,因为,LTE的CRS随着小区的PCI在频域的符号是有变化,而且NR的DMRS也会随着天线端口变化,考虑从RE级规避是不现实的。
image

图3-13 NR PDSCH DMRS放置示意图(1)

将最后一个DMRS的符号位置移动一下,可行嘛?如图3-14,把NR的第三个附加导频符号往后移动一个,可以完美的避开LTE的CRS,不论是1/2/4port的哪种场景都OK。

image

图3-14 NR PDSCH DMRS放置示意图(2)

3.3.4 上行链路的调整

在NR和LTE中均使用15 kHz SCS的时候, NR载波不会与LTE载波完全映射在同一频率网格上。 NR和LTE上行子载波映射之间的差异约为7.5 kHz,如图3-16所示。需要加以缓解,否则会由于 LTE和NR的非正交子载波而引起载波间干扰。为了应对这种情况,在NR需要引入了7.5 kHz频移,这是所有进行动态频谱共享部署的必需功能。此处的偏移通过sib消息通知UE,配置项如图3-15所示。

image

图3-15 NR上行频偏的配置项

image

图3-16 NR PDSCH 上行移频示意图

3.3.5 需要的UE能力

为了在LTE和NR频谱的共享共存的过程中,让业务保持下去,在不改变LTE网络的前提下,需要NR UE的支持一下几个功能:

  • 支持PDCCH放置在符号2

  • 能进行LTE-SSB的rate-matching

  • 支持TRS放置在符号6和10

  • 支持灵活的CSIRS放置

  • 当配置LTE CRS的时候,支持附加导频符号后移

  • 上行7.5kHz的偏移

  • 当配置LTE CRS的时候,支持LTE CRS的ratematching

  • 支持NR pdsch typeB的映射方式

表4-1 中国区三大运行商的频谱和DSS的需求情况

电信运营商 5G频谱 存量频谱 动态频谱共享的需求
中国移动 N41 2.6G 160M/N79 4.9G 100M 2.6G TD-LTE 2.6G TD网络的主力频段,中移动独享超大带宽160M,DSS需要适配大带宽网络
中国电信 N78 3.5G 100M 2.1G FDD-LTE 3.5G不需要DSS,2.1G需要
中国联通 N78 3.5G 100M 2.1G/1.8G FDD-LTE 3.5G不需要DSS,2.1G需要
4. 如何设计自己的动态频谱共享方案?

5G在发展和部署的阶段,逐渐模糊了宏站和小站的区别。在客户来讲,他们似乎并不觉得小站要比宏站差多少,除了规格的和尺寸之外。从各大主设备厂商的主力产品和他们面向的的大众市场来看,他们基于需求和场景的差异,对动态频谱共享各自的侧重点。参考宏站厂商的策略, BaiCells该如何布局动态频谱共享。

4.1 华为和中兴TDD动态频谱共享的需求背景

中兴和华为面对的大本营市场是TDD的NR网络,中移动是市场的关键。中移动的2.6G频谱中有存量的LTE网络;由于带宽比较大,让LTE和NR共存的方式进行动态频谱共享,并不适应大带宽的部署;而且,他们的主设备是MIMO 8T8R的TDD以上的设备,不适合进行符号级的共享,因为LTE大多数并没有走进8流以上的MIMO;除此之外,处理多MIMO的符号级共享实现的复杂的更高,带宽利用率也不理想,在上下行共slot的时候会浪费更多。基于这些考虑,针对中移动的载波级共享的,华为和中兴提出了动态频谱共享的Hybrid DSS和 Super DSS,在3.2节中已经介绍。针对电联的FDD的网络,华为和中兴的实现与爱立信和诺基亚并本质的区别,场景更突出,这里就不讨论。

image

图4-1 TDD 100M 40M在动态频谱共享示意图
4.2 爱立信和诺基亚在FDD动态频谱共享的需求背景

在c-band的大带宽频谱范围内,没有考虑频谱共享,因为这些频谱中不存在LTE网络。在欧美,频谱价格比较昂贵,每个运行商拿到的频谱范围都有差异,面对昂贵的频谱和中高频覆盖的劣势,每个运营商拿到频谱有限; 这些优势带宽,在北美被军事用途占据不发提供运营; 只有穿透力更弱的FR2频谱, 面对这样的现实问题,低频段广覆盖的优势,在5G部署的时候显得格外珍贵。在这样的背景下,爱立信和诺基亚分别提出了自己的基于动态频谱共享的方案。

表4-2 欧美主要地区频谱现状

市场区域 5G频谱 主要存量频谱 动态频谱共享的需求
北美 C-band 被军用卫星占用授权FR2的频谱 Low band FDD 高频不需要频谱共享,频谱太贵,低频需要重耕使用
欧洲 C-band和FR2的频谱 Low band FDD 高频不需要频谱共享,频谱太贵,低频需要重耕使用

诺基亚的方案与爱立信的本质上并无太大的差别,在低频段FDD网络部署动态频谱共享,通过低频与中频的CA扩展中频的覆盖。在处理的时间间隔上,诺基亚通过对比不同时间切换网络收益情况,采用了10ms的周期切换间隔。认为10ms在回报比和开销上是最好的。诺基亚还提到了网络切片技术是DSS的发展方向。

image

图4-2 诺基亚动态频谱共享解决方案

图4-3为爱立信的频谱共享解决方案,通过中频+低频网络的结合,成倍的扩展5G的覆盖;同时也解决了快速部署5G网络的烦恼。在部署中,通过上行行开关控制频谱共享的链路方向,在UE支持同时中频和低频的band时,利用载波聚合,结合中频和低频的频谱,这样就可以让远、中、近的用户都感受到NR网络便利。爱立信实现了1ms的高效快速地动态频谱共享。相应的技术细节在3.3节已经介绍。

image image

图4-3 爱立信的动态频谱共享部署解决方案

查找动态频谱共享在TDD的实现的相关内容,看到了罗德公司关于DSS在TDD的描述[2]。从问答的描述可以看出,实现DSS的关键工具MBSFN主要是为FDD设计的,TDD的网络基本不需要与LTE共享(除了中移动160M的频谱),因为5G的TDD网络在欧美,不是没事用就是对LTE不可用,因此对DSS的需求也几乎没有。

image

图4-4 关于DSS的部分问答

针对不同客户的不同场景,你的解决方案是什么呢?

参考资料

[1]. 33060-dynamic-spectrum-sharing-is-a-game-changer
[2]. DSS_QA.pdf
[3]. 33239-nr-and-lte-coexistence-through-dynamic-spectrum-sharing
[4]. 5G_DSS.html#Ref_05
[5]. Dynamic-Spectrum-Sharing-WhitePaper-PDFDSSWP-031320.pdf
[6]. (A4) 5G NR Dynamic Spectrum Sharing Drivers & Test Implications_Alex Liang.pdf
[7]. implementing-dynamic-spectrum-sharing
[8]. article-dss-enabling-5g-nr-in-standard-lte-subframes-part-1-_254008.html#media-gallery-7
[9]. sarticle-dss-5g-nr-lte-coexistence-through-dynamic-spectrum-sharing-part-1-_254002.html#media-gallery-8
[10]. implementing-dynamic-spectrum-sharing
[11]. nr-lte-coexistence-dynamic-spectrum-sharing-dss
[12]. RWS-180011.pdf
[12]. dynamic-spectrum-sharing-for-5g-nr-and-4g-lte-coexistence
[13]. new-3gpp-effort-on-nr-in-unlicensed-spectrum-expands-5g-to-new-areas.pdf
[14]. 2020-08-26_ITU_Spectrum-Planning-for-Emerging-Technologies_Ericsson.pdf
[15]. 1805.05591.pdf
[16]. public_policy_position_5g_spectrum.pdf
[17]. dss-the-5g-deployment-x-facto
[18]. 10109-Industry-s-First-Tri-RAT-Dynamic-Spectrum-Sharing-Solution-for-Realizing-Fast-5G-Deployments
[19]. 33867-zte-and-china-unicom-implement-industrys-first-tri-rat-dynamic-spectrum-sharing-solution
[20]. dynamic-spectrum-sharing-standardization
[21]. first-cloudair-lte-tdd-nr-dynamic-spectrum-sharing-commercial-verified-by-china-mobile-and-huawei

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. SR达到最大重传次数
  • check UE的盲检位置能否对上

  • BWP的位置是否正确,若基站已经切换了BWP,而UE还在BWP上解调就解不出DCI

  • 聚集级别是否正确 1CCE = 6REG

2. DCI漏检问题
  • 检查PDCCH是否存在问题
    -SSR波束和RACH波束是否使用正确,SSB用cell的静态波束,RAR用RACH的测量波束;普通的数传报文,有SRS波束用SRS波束,没有SRS听RACH波束;

  • check DCI类型数值value是否正确

  • L2下发的L1报文是否被L1校验

  • 查看是否有大量的DTX,看UE接收到的DCI个数是否满足是满的

3. 影响峰值速率的因素
  • pdcch_grant不足,以100M,30kHz,上下行时隙配比8:2,pdcch dl/ul grant 分别是1600次和400次;

  • RB调度不足,100M在每个时刻都有对应的RB数,平均下来峰值场景大概265个RB;

    pdcch_grant不足和RB调度不足可以归纳为调度不足,主要看(1)是否有来水不足;(2)是否有AMBR限;核心网开户信息中包含了两个重要息:AMBRQCI。AMBR限制了UE的Non-GBR速率;用户QCI信息会与基站侧的QCI级的PDCP、RLC相关定时器参数(包含SN bit数、RLC模式等)进行关联,从而影响到用户的吞吐率性能;UE AMBR/QCI信息可以通过S1口跟踪S1AP_INITIAL CONTEXT SETUP REQ或者X2口SgNBAdd Req查看。(3)是否有DCI漏检,查看CSI-RSRP,是否是覆盖差导致DCI漏检;检查配置查看PDCCH聚合级别,聚合级别太低会造成DCI漏检,推荐自适应;DCI资源不足,调度用户数太多也会导致DCI漏检;(4)传输问题,如果是TCP业务,先通过UDP灌包排查是是空口问题还是TCP问题;
    针对上述问题总结下来主要可以归纳为以下三类

协议栈 影响因素
PDCP 入口流量不足,缓存满丢包,超时丢包,PDCP SN长度不够
RLC RLC入口流量不足,RLC重传,RLC窗口满停止调度
MAC harq资源耗尽,DCI漏检
  • mcs低,MCS反应的是信道质量SINR映射到CQI关系,**(1)当CQI比较低,MCS会比较低,要跑满调度,就需要提升CQI;(2)当基站接收功率过高,引起接收器件的削波,导致SINR降低从而导致MCS下降,会使速率下降; 一般情况下,CSI-RS SINR>25dB,CSI-RSRP在(-65dbm~-80dbm),不宜超过-65dBm;(3)时频偏问题(4)干扰问题,主要分为邻区干扰、越区干扰和外部干扰。邻区干扰一般由于邻区过覆盖对当前小区产生干扰;越区干扰,需要看是否有较远距离的小区越至服务小区的范围;外部干扰,需要进行扫描人工分析;当出现高RSRP低SINR(如:RSRP均值>=-80dBm,SINR均值<=15dB)且MCS等指标都偏低,那么就有必要进行干扰问题排查**;

  • mcs/rank 被固定,导致UE无法调度更高的mcs和rank;

  • cqi上报异常,CQI上报分为CSI-RS异常和SRS异常,(1)CSIRS异常,CSIRS基站侧配置端口数与测试终端数不一致时会导致CSI/CQI测量异常,导致UE无法上报CQI,此时会导致mcs&rank低;(2)SRS异常,Massive MIMO主要通过SRS信号来做上下行互异性,基站收到终端上报的SRS或,才会下发CSI测量,UE才会上报CSI测量(CQI/PMI/RI), 然后网络侧基于UE上报的CQI进行链路自适应;因此SRS异常会使CQI异常。

  • rank低,rank用来指示PDSCH的有效的数据层数,Rank最大值min(gNB天线,UE天线数),一般基站的天线远大于UE的天线数,因此rank主要取决于UE端的天线数。(1)测试环境【优先选择站下近点,CSI-RS SINR>25dB,CSI-RSRP在(-65dbm~-80dbm),不宜超过-65dBm】;(2)小区间频繁切换,切换后用户初始接入,低RANK、低MCS能保证接入和切换成功率,切换后初始的RANK值默认为1,大概在30ms左右可调整回来,影响较小;但是如果发生频繁切换,会导致RANK无法快速爬升。(3)MCS表频繁切换, MCS表格切换指的是在一定条件下进行64QAM和256QAM的MCS表格切换。在切换期间RANK固定为1进行调度; (4)终端能力,协议规定单用户下行最多可支持8流;上行最多可支持4流。

  • 通道校正异常,通道校正失败后,系统由于无法准确评估SRS权值,所以会默认使用DFT开环权进行业务,gNB会根据UE上报的RI来选择rank,遵从如下规则:
    1)UE CSI的RI为1,则当前使用RANK为1;2)UE CSI的RI为2-3,当前使用RANK为2;3)UE CSI的RI为4-8,则当时使用RANK为4。

  • 下行SRS权与PMI权自适应,下行SRS权与PMI权自适应,允许用户在SRS SINR较大时,选择基于SRS得到的BF权值;在SRS SINR较小时,选择基于PMl的BF权值,相对于SRS权,远点用户的PMI权可以提升权值准确性,提升边缘用户的SNR,进而提升边缘用户的速率;1)当用户上行SRS SNR大于ThsRs(默认-2dB)该用户选择SRS权;2)当用户上行SRS SNR小于ThpMl(默认-8dB)该用户选择PMI权;3)当用户的SRS SNR在ThsRs和ThpM之间时,该用户权保持不变;当使用SRS权值时,基站使用Rank自适应算法确定最终使用Rank值;使用PMI权时,Rank自适应算法不生效,直接使用UE上报的RI当PMI未上报,或刚刚切换,或通道校正未通过时,则使用DFT权,根据UE上报的RI来选择Rank,但遵从如下规则1)UE CSI的RI为1,则当前使用RANK为1;2)UECSI的RI为2-3,当前使用RANK为2;3)UECSI的RI为4-8,则当时使用RANK为4;

4. 切换后流量不足掉坑
  • 检查切换前后流量是否已经降低;

  • 切换的时延是否异常,如时延过大;

  • 切换后来水不足导致调度不足;

  • 切换后MCS异常,rank异常;

  • 切换前后是否存在多径,频偏过大;

  • 其他,比如干扰等;

5. rank和mcs不符合预期
  • rank不符合预期:(1)确认UE的天线数,L3配置的CSIRS port数是否大于等于UE上报的RI;(2)rank自适应是否正常;

  • 误码较低的时候mcs差:(1)当前是否处于弱覆盖;(2)下行频段较大;(3)权值自适应异常;(4)上行TA异常;其他参考影响峰值的内容

参考文献:

[1]. xxx厂问题定位指导书

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

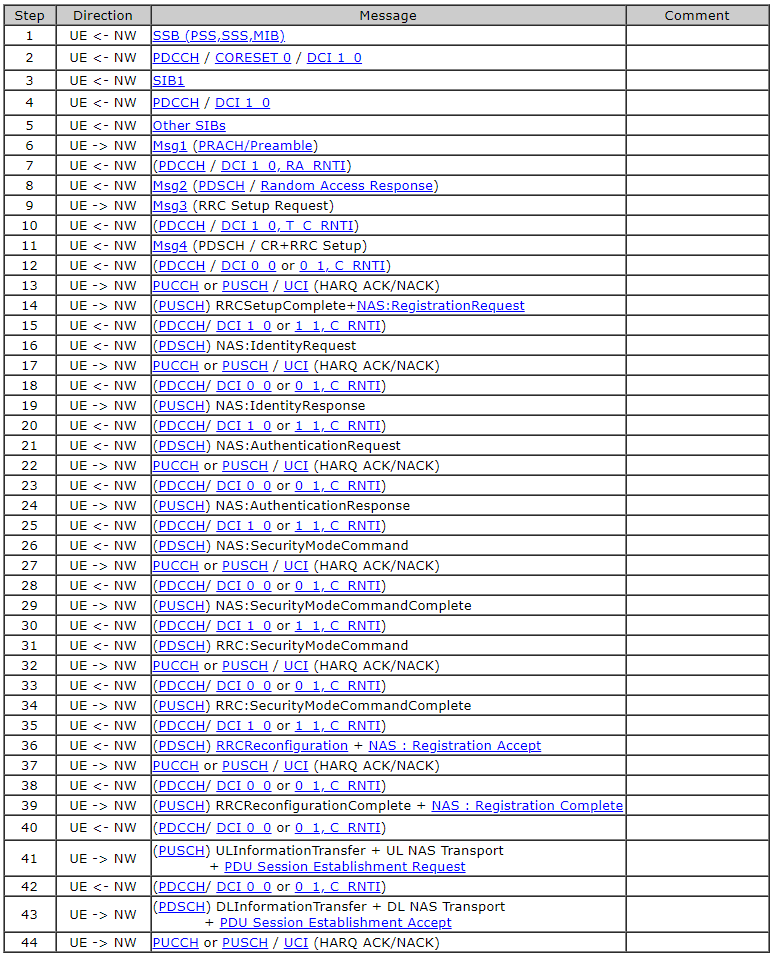
UE的接入无线承载网的过程,分为初始接入和随机接入两个过程;以下是NR SA的场景下的通过空口在UE和NW(网络)之间信令流程:
image

1. 初始接入

UE通过基站广播的PSS/SSS信息对齐频率、时间以及获得接入所需要的参数:

  • 基站广播PSS/SSS/PBCH Block(SSB):一个SSB有4个OFDM符号由PSS/SSS/PBCH组成,频域上有240个子载波(0-239编号)20个RB(一个RB12个子载波),协议38.211 7.4.2章节描述定义;

  • UE检测到一个SS/PBCH Block,定位到PSS和SSS之后,UE便可以在时频域知道MIB消息的位置,应为MIB消息的位置是相对PSS和SSS固定的,MIB消息的内容有子载波间隔、PBCH的DMRS符号位置、SIB1所在的时频位置(由L3的PDCCH-Config SIB1配置)和频带大小、是否禁止用户驻留、是否容许用户直选到同频邻区等;解到MIB之后就可以解码PBCH的内容,获取SS/PBCH index、定时等信息;SSB Block Pattern有五种case A-E(1)SUB3G(A-C)其中FDD频段最大4个SSB Block,每个对应一个SSB Index;(2)sub3G-sub6G A-C定义8个SSB;(3)Above 6G (D-E)定义64个SSB;

38.321 6.1.4 MIB/SIB/OSI消息格式

SIB1消息提供了UE准许接入和OSI调度的信息,以及初始BWP相关的频域位置和带宽,寻呼,PRACH接入等关键信息;SI-SchedingInfo 中SIB1字段中的valueTag字段在SI消息发生变化时都是加1,用于指示SI消息是否发生变化,UE使用这个字段检测自己之前保存的SI消息是否发生了变化;

  • UE根据mib中中内容获取RSMI所在的频域位置(初始BWP的位置,PDCCH common coreset的视频位置),然后获取RMSI,并从RMSI中获取RACH的位置信息,上下行初始BWP的信息、PUCCH的配置等信息。

BWP0阶段 PDCCH信道频域RB的位置与PDSCH信道是一致的

  • UE在对应的RACH occasion上发送RACH Preamble。
2. 随机接入
  • 随机选择preamble Id发送preamble:UE从SS_RSRP大于RSRP_ThreadSSB选一个SSB-RSRP最好的SSB波束。如果没有最好的额,就随机选一个SSB波束,在从SSB的preambles中随机选择一个preamble Id发送preamble,告诉基站有一个随机接入请求,并使基站估计与UE之间的传输时延,以便基站校准uplink timing并通过RAR的timing advance command告知UE;基站通过sib1广播告知UE,基站的RACH信道的视频位置、preamble序列格式、序列产生的参数等信息,用来解答UE在什么时候(prach-configuration-Index)以在什么位置(prach-frequencyOffset)以什么格式(prach-configuration-index)多大的功率(min(Pmax, PREAMBLE_RECEIVED_TAR_GET_POWER+Rl))发送RA

preamble的作用:告诉基站有一个随机接入请求,并使基站估计其余UE之间的传输时延,以便在RAR中下发TAC;

  • 基站下发RAR:基站对不同的preamble分配不同(的TC-RNTI和UL-Grant资源等,并通过preamble测量到初始的TA值,在RAR中发送给UE;UE在发送Preamble之后,会在RAR的响应时间窗内,监听PDCCH以接收对应RA-RNTI的RAR;基站侧用RA-RNTI加扰的PDCCH的公共搜索空间中的的DCI1-0告诉UE。如果UE在时间窗时间内发生
    (1)在时间窗内用RA-RNTI没有盲检到DCI
    (2)没有盲检到PDCCH CRC错误
    (3)RAR中的RA-PID与preambleId不一致
    就认为本次RA接入失败;UE RA失败后重发preamble与RAR PDU中的BI(backoff Indicator)字段相关,如果RAR PDU中的携带了BI,那么UE会在0-BI中随机选取一个时刻重新发preamble接入;BI的大小反映了小区的负载

RAR的响应时间窗(RA Response Window)在rach-configGeneric中配置,配置项为ra-ResponseWindows单位是slot;

RAR调度流程

-
UE发msg3 RRC_SETUP_REQ RRC承载建立请求:UE收到RAR之后,通过解析,RAR的payload获取msg3发送时刻的视频资源,采用的mcs和功率等信息,UE在这个过程中会发送一个39bit的随机值(申请RRC Setup请求);首次发送msg3时以RV版本号0发送(默认顺序0-2-3-1),若基站收到msg3 CRC错,则会基站通过以TC-RNTI加扰的DCI format0-0将信息告知UE;==UE发送完成后msg3后会启动Ra-COntentResolution定时器(这个定时器在sib1中的RACH-Config-Common中配置),在这个定时器期间UE会等待基站是否让自己接入,也就是冲突解决的过程;

-
基站发发msg4 RRC_CONN_SETUP,并进行冲突解决: 在CCCH上发送,携带SIB1资源的配置的详细信息,同时如果有竞争接入会有竞争解决的过程,(冲突解决)基站把msg3的钱48bit作为UE Contention Resolution Identity MAC CE发送,其中包括了mcs的39bit随机值;msg4通过preamble Id和Tc-RNTI发送,终端收到ms4之后,会把竞争解决的MAC CE解析出来,和自己的msg3的前48bit对比,如果相等则认为自己竞争成功,否则竞争失败,在sib1的定时器之后再重新发起接入;

UE时RRC非连接态:通过网络侧提供的S-IMSI作为标识,如果没有提,使用一个39bit的随机值作为临时标识,并通过CCCH告诉基站,基站在msg4时通过UE冲突是否解决;
UE时RRC连接态:msg3中UE通过C-RNTI MAC CE将自己的C-RNTI告诉基站,msg4中基站用这个C_RNTI来解决冲突。

  • UE发msg5 RRC_CONN_SETUP_COMPLETE,完成RRC链接建立:通过DDCH的SRB1承载发送,携带上行方向的NAS消息,基站收到RRC_CONN_SETUP_COMPLETE消息之后,RRC链接建立完成,SRB2承载就会随之建立。

  • 初始上下文建立: 建立UE与AMF的之间的绘画,让UE与AMF之间保持交流,由AMF发起,初始上下文建立完成就表示UE与AMF之间完成连接;

  • UE能力查询:UE能力主要有UE的天线能力(也就是支持的频段等信息)和UE的网络能力(加密算法,NAS等的支持情况);基站根据核心网在UE上下文建立的请求中是否携带了UE能力,来决定是否进行查询,如果UE携带了则不下发UE能力查询。
    下图是NR SA UE注册的流程示例,从msg3一直到注册完成

image

参考文献
[1]. 5G Standalone Access Registration Signaling Messages
[2]. 5G Standalone Access: Registration Procedure
[3]. 5G/NR-初始Aattach

3. 随机接入触发的场景

随机接入并不是只有新入网才会触发,还会发生在一些已经入网的UE身上,梳理出来主要有一下8大场景;

  • 初始RRC连接建立:当UE需要和基站建立连接时,UE会发起随机接入;

  • RRC重建:当UE需要和基站重新建立RRC连接时;

  • UE进行切换时:UE会在目标小区发起随机接入;

  • 下行数据到达:UE处于RRC连接,有UE有下行数据要发送,但发现UE失步,此时基站会通过下行控制信令让UE发起随机接入;若UE处在DRX休眠,则需要等UE变为Active后再下发控制信令;

  • 上行数据达到:UE处于RRC连接,有UE有上行数据要发送,但发现UE失步,UE会发起随机接入;

  • NSA接入,LTE小区接入,添加NR小区时,会发起随机接入;

  • 基于RA请求SI:当UE需要请求特定的SI时,会发起随机接入;

  • 当UE处在RRC-INACTIVE:(1)主动迁移到RRC-CONNECTED时,UE会发起随机接入;(2)基站需要UE迁移到RRC-CONNECTED是,基站会通过paging让UE发起随机接入;

其中1、2、5是竞争接入;3、4是优先非竞争接入,如果没有转悠preamble触发就是竞争的随机接入;6、7是非竞争接入;8如果是UE发起的就是竞争接入,如果是网络侧发起的就是非竞争接入

4. RRC重建与重同步
4.1 RRC重建

RRC重建是快速建立RRC连接的一种业务,重建的前提是UE已经与基站建立RRC连接,且已经成功启用安全模式,才能发起RRC重建;若是安全模式激活前发起重建,会发生重建失败,UE直接进入IDLE态,主要在以下几个场景中会触发RRC重建

  • 检测到无线链路链接失败(38.331 5.3.10),主要有T310超时RA失败且T311未运行RLC达到最大重传

  • NR-RRN系统内,异系统切换失败;

  • L3收到底层完整性校验失败的报告;

  • RRC连接重配失败;

4.2 重同步

重同步的过程是UE重新接入的过程,是在UE或者基站有上行或者下行数据要发送时发现UE与基站失步了,由UE主动发起或者基站被动发起的同步动作;

  • 对于SA基站收到msg4的ACK就认为上行同步;

  • 对于NSA基站收到UE发送的首个数据报文(msg5)就认为上行同步;

重同步的触发

  • UE有上行数据要发,UE发现上行失步,有UE发起竞争重同步;

  • 基站有下行数据要发,发现上行失步,有基站触发UE发起竞争重同步;

  • SUL场景上下行数据到来,会触发重同步;

在基站和UE维护和管理同步状态是由一个同步定时器

  • 当UE收到基站的TA MAC CE时,会重启定时器;

  • 基站收到UE的TA MAC CE时,也会重启定时器;

参考文献:
[1]. xxx大厂问题定位指导书

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. 时隙结构

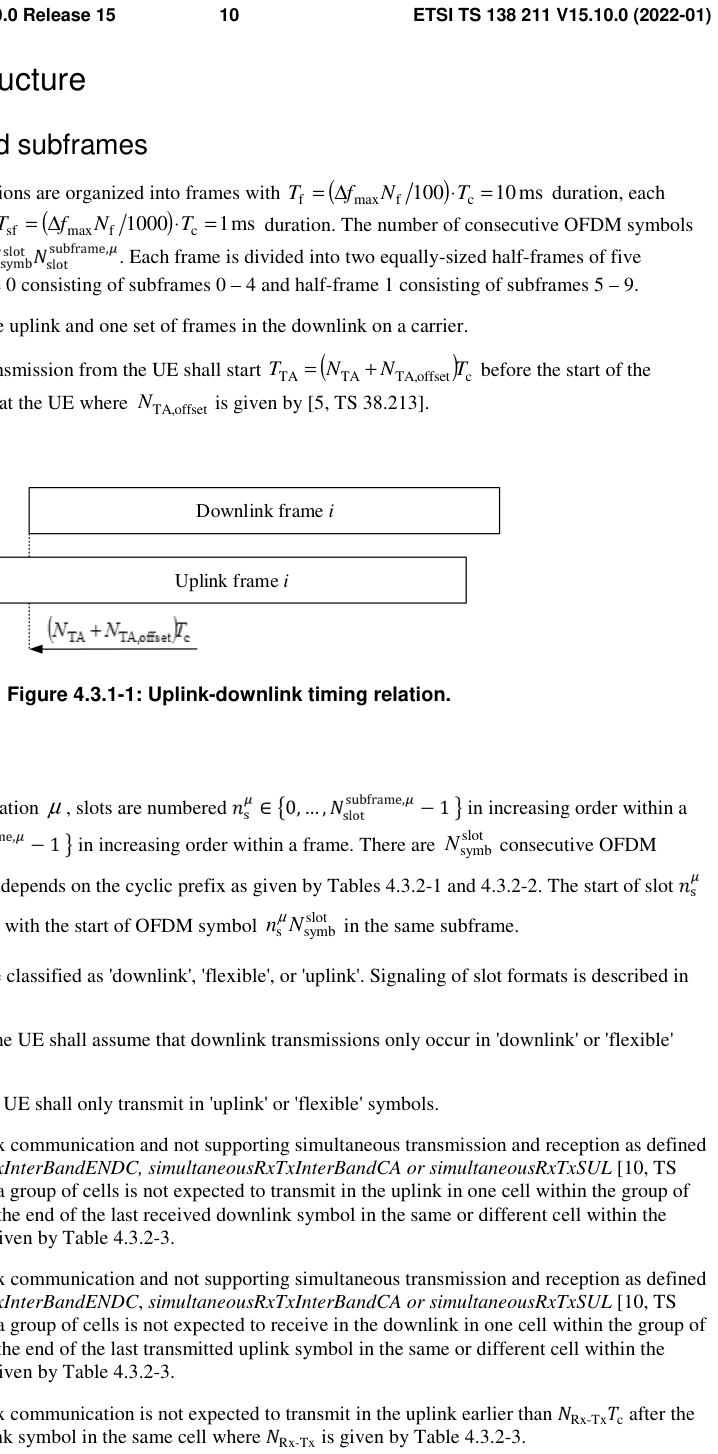
LTE的子载波间隔是固定的15kHz,在NR中针对不同频谱的应用场景设计了5种不同的子载波间隔,图下表:

image

无论是哪种子载波间隔,每个RB包含的子载波个数仍然是12个。在NR中,对于normal CP类型,每个slot包含的符号数是14,每个帧包含的slot数根据子载波间隔的不同也有差异。
image

在NR里,每个frame帧仍然包括10个subframe子帧,每个子帧的长度固定是1ms。子载波间隔越大(即频域越宽),相应的slot时间越短(即时域越窄),相应的每个symb符号长度也越短。
上表列出了NR支持的5中不同的帧结构,对应不同的μ,有着不同的帧结构。

2. [slot Format](#slot Format)

时隙格式slot format,是用来表示一个时隙里的每个OFDM符号的传输方向是什么;在NR中,一个时隙里的OFDM符号,被分类为三种:DL符号、flexible符号和UL符号。在TDD的系统就对应成DL slot、S slot 和UL slot;下行数据可以在DL符合和flexible符号中传输,上行数据可以在UL和flexible中传输。在38.213-f60协议中,定义了56中时隙格式,如下表所示:

image

为了能够调度的更加灵活,定义这么多的时隙格式,当前下行的数据负载很大,可以配置Slot Format 28#;当前上行的数据负载很大可以配置SlotFormat 34#。有这么多slot format,系统是怎么下发这个Slot Format配置?UE收到Slot Format配置之后,是怎么处理的呢?

3. [UE如何获取基站的slot format](#UE如何获取基站的slot format)

上表的第一列是Slot Format Indicator,指示当前基站采用的时隙格式,该参数由基站侧配置并下发到UE。UE可以通过解析系统信息来获取小区的时隙格式Slot Format,也可以通过解析特定的DCI来更新时隙格式。

系统消息获取slot format ?

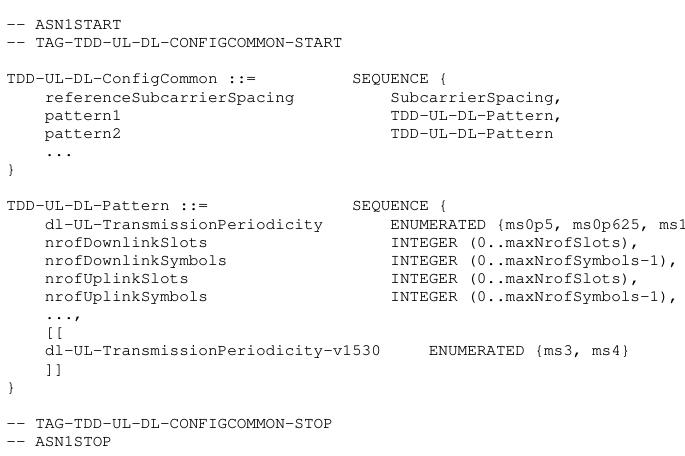
SIB1中ServingCellConfigCommonSIB信元用于配置UE所在服务小区的小区特定参数,ServingCellConfigCommonSIB信元里有名为TDD-UL-DL-ConfigCommon的信元,该信元用于确定小区特定的上下行TDD配置;时隙格式相关的参数就可以通过解析TDD-UL-DL-ConfigCommon信元中的TDD-UL-DL-Pattern信元得到。UE获取到这些参数后,就可以得到当前基站的上下行时隙格式。
TDD-UL-DL-Pattern
image

  • dl-UL-TransmissionPeriodicity:表示DL-UL模式的周期,用变量P表示,单位是ms,它的取值范围是ms0p5, ms0p625, ms1, ms1p25, ms2,ms2p5, ms5, ms10,分别对应0.5ms、0.625ms、1ms、1.25ms、2ms、2.5ms、5ms、10ms。

如果我们用变量u_ref来表示referenceSubcarrierSpacing这个值,那么:(1)只有当u_ref=3的时候,P才能取0.625ms,此时如下表所示,子载波间隔为120kHz。(2)只有当u_ref=2或3的时候,P才能取1.25ms,此时子载波间隔为60 kHz或120kHz。(3)只有当u_ref=1或2或3的时候,P才能取2.5ms,此时子载波间隔为30kHz或60 kHz或120kHz。

  • nrofDownlinkSlots:表示从每一个DL-UL模式的开始位置起,全部连续的下行时隙的个数,用变量d_slots表示。最小值是0,目前的R15版本协议规定最大值可以取80

  • nrofDownlinkSymbols:表示从最近的一个全连续下行时隙开始,连续的下行符号个数,用变量d_sym表示。最小值是0,最大值可以取13。

  • nrofUplinkSlots:表示在每一个DL-UL模式的结尾处,连续全上行时隙的个数,用变量u_slots表示。最小值是0,目前的R15版本协议规定最大值可以取80。

  • nrofUplinkSymbols:表示在第一个全上行时隙之前的最后一个时隙中,连续全上行符号的个数,用变量u_sym表示。
    dl-UL-TransmissionPeriodicity参数可以取8个周期值,这8个周期值,有一定的规则约束需要遵守,

从DCI里获取slot format ?

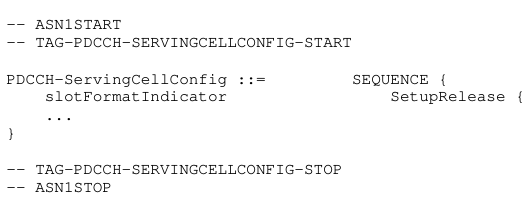
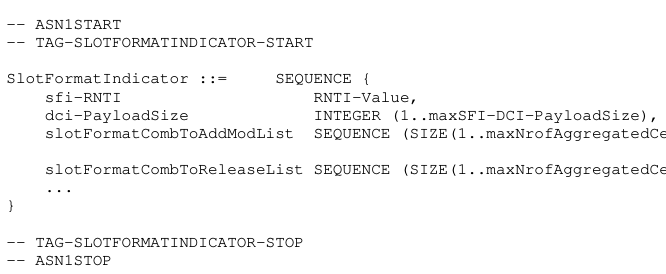
R15版本的38.213中表7.3.1-1中定义了8中DCI formats,其中DCI2_0指示UE组的slot format。DCI 2_0用SFI_RNTI (Slot Format Indicator- Radio Network Temporary Identifier)来加扰,SFI_RNTI在RRC的PDCCH-ServingCellConfig信元中的SlotFormatIndicator信元中得到.
PDCCH-ServingCellConfig information element
image

==SlotFormatIndicator information element==
image

image

DCI 2_0码流中携带的是N个slot format indicator的比特流,格式为:

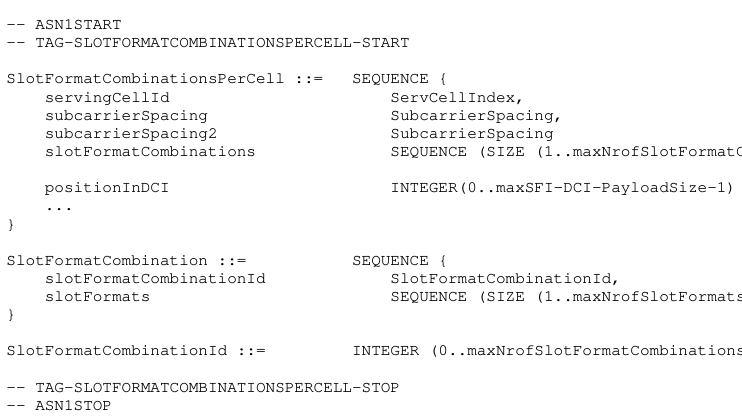
DCI 2_0的码流大小由上边的dci-PayloadSize配置决定,最多可以携带128bits。DCI 2_0码流中的Slot Format Indicator为SFI-Index,只是一个ID索引号,范围是0~511;SFI-Index都对应一个SlotFormatCombinationsPerCell信元,这个信元被封装在SlotFormatIndicator信元中。

SlotFormatCombinationsPerCell information element
image

image

SlotFormatCombinationsPerCell information element中的slotFormats参数才是真正的时隙格式参数,对应这个slot flormat的表中的第一列indicator 0-255slotFormatCombinationId是DCI2_0码流中SFI_Index


DCI 2_0能够动态的修改时隙格式参数并通知到UE,为了进一步提升系统的传输性能,DCI 2_0里尽量只考虑携带有限个比特的SFI_Index索引,UE在提取到N个SFI_Index之后,再通过匹配SlotFormatCombinationsPerCell信元中的slotFormatCombinationId字段,获取到SlotFormatCombinationsPerCell信元中的更多参数。

参考文献
  • 3GPP TS 38.211: “NR; Physical channels and modulation (Release 15)”

  • 3GPP TS 38.212: “NR; Multiplexing and channel coding(Release 15)”

  • 3GPP TS 38.213:“NR; Physical layer procedures for control (Release 15)”

  • 3GPP TS 38.331:”NR; Radio Resource Control (RRC) protocol specification (Release 15)”

  • http://www.sharetechnote.com

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

函数对象,一个类如果将()运算符重载,那么这个类就称为函数对象类,使用形式看起来像函数调用,实际执行了函数调用,因此坐函数对象。**lambda表达式**也称匿名函数,是无需定义标识符(函数名)的函数,如果函数只使用一次或者有限的次数,使用lambda表达式会比较方便。

1. 函数对象的如何实现?

C++中将对象当做函数使用,是函数式编程的思想。这里不作深入讨论,只讨论如何使用;举个简单例子:
【1】无入参的函数对象:

1
2
3
4
5
6
7
8
9
10
11
12
13
class ObjType
{
public:
void operator() () // 无参数类型的()重载
{
cout
T accumulate(InIt first, InIt last, T val, Pred opt)
{
for (; first != last; ++first) {
init = opt(init, *first);
}
return init;
}

模板被实例化之后,opt(init, *first)需要定义,opt只能是函数指针或者函数对象。在使用时,实参只能传递函数名,函数指针或者函数对象。这里以函数对象为例举例说明:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
#include 
#include
#include
template
class SumPow
{
public:
SumPow(int pow) :m_pow(pow) { }
const T operator() (const T& total, const T& value)
{ //计算 value的pow次方和
T v = value;
for (int i = 0; i a2 = { 1, 2, 3 };
// 实例化为函数指针
cout (2)) (2)) ::iterator first, vector ::iterator last, int init, int(*op)(int, int))
{
for (; first != last; ++first)
init = op(init, *first);
return init;
}

参数SumPow<int>(2)编译器实例化成了函数对象,有等效于如下定义的形式,形参是函数对象,相当于调用opt.operator()(init, *first);,也就是SumPow类的operator函数;

1
2
3
4
5
6
int accumulate(vector::iterator first, vector::iterator last, int init, SumPowers op)
{
for (; first != last; ++first)
init = op(init, *first);
return init;
}
2.lambda表达式

在使用STL的时候,往往需要用很多函数对象或者函数指针。这些对象或者函数指针大部分是一次性,编写在需要的时候编写这样的代码有点浪费。对于只使用一次的函数对象或者函数,lambda表达式是一个有效的解决办法。Lambda表达式也是的闭包的同义词,但是两者也是有区别的,闭包是任何能够访问不在局部和参数列表里定义里面的自由变量的函数实例。C++中的lambda在C++11中才支持。Lambda 表达式的定义形式如下:

1
[外部变量访问方式说明符](参数表)->返回值类型{语句块}

外部变量访问方式说明符=&,表示{}中用到的按值捕获还是按引用捕获, 按值捕获表示定义在{}外面的变量,在{}中不允许被改变,按引用捕获表示允许修改。当然,在{}中也可以不使用定义在外面的变量。**->返回值类型可以省略。如下是一个lambda表达式**:
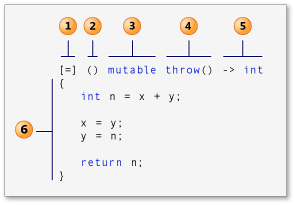
如果上边不够直观的话,看下边这个图,就更一幕了然。其中,1是捕获说明符;2是捕获参数列表;3是可选的mutable声明;4是可选的异常声明;5是返回类型;6是lambda操作域;
image

** 捕获列表 capture clause **

捕获 作用 捕获 作用
[] 不捕获任何变量 [] 不捕获任何变量
[&] 引用捕获所有变量 [=] 以值捕获所有变量
[&x] 引用只捕获x [x] 以值只捕获x
[&, x] 引用捕获所有变量,x是例外 [=, &x] 值捕获所有变量,其中x是例外
[this] 以引用捕获当前对象 [*this] 以传值方式捕获当前对象

捕获列表 capture clause
举个例子,如果lambda主体total通过引用捕获变量,factor通过值捕获变量,则以下捕获子句是等效的:

1
2
3
4
5
6
[&total, factor]
[factor, &total]
[&, factor]
[factor, &]
[=, &total]
[&total, =]

如果捕获子句默认& 按引用捕获,那么identifier在capture捕捉列表中不能再有以引用捕获的形式也就是& identifier。同样,如果capture默认按值捕获capture-default =,则capture该捕获列表不能有按值捕获的形式= identifier。而且,标识符不能在捕获列表中出现多次。需要注意的是默认在捕获列表没有明确捕获方式的时候[],根据捕获参数列表传参形式决定是值捕获还是引用捕获, 形如[](int &x){x=x*2;}

1
2
3
4
5
6
7
8
9
struct S { void f(int i);};
void S::f(int i) {
[&, i]{}; // OK
[&, &i]{}; // ERROR: 按引用捕获,在声明i按引用捕获多余
[=, this]{}; // ERROR: this when = is the default
[=, *this]{ }; // OK: captures this by value.
[i, i]{}; // ERROR: 重复声明捕获
[=]{++i;}; // ERROR: 值捕获,不能修改对象
}

说了这么多,lambda具体怎么用呢?看一看,下边的例子:

int main()
{   
    int a[4] = { 11, 1, 37, 9 };
    /* 按值捕获 捕获值不可修改*/
    sort(a, a + 4, [=](int x, int y) -> bool {return x 感谢您的阅读-------------


坚持创作,坚持分享!

  
    打赏


        ![liurui 微信支付](/images/wechatpay.png)
        
微信支付


        ![liurui 支付宝](/images/alipay.png)
        
支付宝

崇拜信仰,笔者买了一个公版2060Super,刚挂起来,很久没用过独显了。以为直接可用;然而遇到了一些坑,前前后后,大概花了一周才搞定,期间还拿到店铺老板那,检测了一把;虽然问题很简单,这里需要记录一下,希望对后来的同学有用;笔者的配置情况如下表:

软&硬件信息 型号 软&硬件信息 型号
处理器 英特尔 i5-8400 主板 Nvidia RTX 2060 SUPER
主板 华硕PRIME Z370-P 电源 爱国者GT-550 550W
内存 4*DDR4 2400MHz 系统 WIN10 2004
1.下载驱动

NVIDIA官方下载对应硬件的最新驱动,下载完成之后,安装即可;

2.安装OK,显卡无法驱动

安装完成之后检查,是否可用,用管理员权限进去CMD,输入NVIDIA-SMI看能否查询到显卡信息。笔者这里没查到显示:Failed to initialize NVML: Unknown Erroe; 这时候直接懵逼了,驱动安装成功了,咋会这样了? 按图索骥,问度娘,貌似很多网友遇到类似的问题,简单归纳一下,主要有一下几类:

  • 系统版本不不兼容,要使用1803以后的版本,这个时候主要表现的问题现象是,驱动与系统不兼容;升级系统版本解决或更换系统至企业版。

  • 驱动版本不对,不应该下载DCH版本,应该在标准版的;解决办法是下载标准版的驱动。

  • 驱动不兼容导致,需要卸载完系统自带的驱动,确保系统自带驱动失效且完全清楚,然后重新安装驱动。删除驱动,提供了DDU v18.0.2.5.exe来清楚系统自带驱动;

结合笔者的实际情况,挨个来看一下这3个问题,首先是系统不兼容,由于笔者系统本身是1803的win10,本着半信半疑的思想,将系统更新到了win10 2004版本;重新下载完所有NVIDIA驱动之后,重新安装,依旧是一样的现象;这个可以排除第一点和第三点;针对第二点的驱动版本不对,当前NVIDIA官方提供的已经没有所谓的标准驱动了,都是DCH的驱动,查询资料和相关介绍确认,win10 在1904版本之后,默认都是DCH且NVIDIA新卡只有当前都是DCH驱动。故排除第二点。

3.问题解决

问题没解决,还要继续看,本着问题不解决誓不罢休的精神,笔者继续排查采坑;为了比对系统的差异,特性下载了ubuntu18.4和ubuntu20.4两个系统,安装驱动尝试能否启动;遗憾的是,不论哪个系统,安装完成之后,系统重启就挂掉了,在等待某个配置校验一样,具体原因没有深究。对比ubuntu和windows,发现不论哪个系统安装都会有问题,这里可以认为,不是系统的问题。可能是硬件的原因。继续排查、检索相关问题,偶然看到某个哥们在网上说,要设置启动模式关闭安全模式,然后接上显卡的电源线即可。根据这个提示,进入了华硕主板的bios,在启动中找到了CMS,选择关闭。F10保存记录,重启。
image
重启又看到提示显卡的电源没接please power down and connect the PCIe power cable(s) for this graphics card;
image
拆开机箱,找到显卡的电源接口,街上电源和8pin的电源,然后上电重启,问题解决。CMD输入NVIDIA-SMI查看一下显卡的信息。
image

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

0%