liurui's blogs

活成期待的样子...

1. malloc和realloc

这两个函数都是申请内存的函数,他们有什么区别和联系呢?那些场景会出现意想不到的结果呢?下面具体探讨这两个函数.

1.1 malloc函数

void *mallco(size_t size); malloc 向系统申请分配指定size个字节的内存空间。返回类型是 void* 类型。

malloc
1、malloc 函数返回的是 void * 类型,定义的哪种类型的指针,必须强转为此类型指针;
2、函数的实参为 sizeof(int) ,用于指明一个整型数据需要的大小;
3、malloc是必须指定内存大小的空间,比如想分配50个int类型的空间:int* p = (int*) malloc ( sizeof(int) * 50 );
4、是malloc 只管分配内存,并不能对所得的内存进行初始化,所以得到的一片新内存中,其值将是随机的;

闲话长谈malloc(0)与malloc(-1)返回值是什么样的?

#include
using namespace std;
int main(){
    int *ptr1=(int*)malloc(sizeof(int)*(0));
    int *ptr1=(int*)malloc(sizeof(int)*(-1));;
    cout 
**If size is zero**, the return value depends on the particular library implementation (it may or may not be a null pointer), but the returned pointer shall not be dereferenced.

表明**malloc(0)**是跟据,不同库的设置有着不同的表现,翻翻glibc(是GNU发布的c运行库,linux系统中最底层的api)的源码瞅瞅,有如下的说明:

> 
**If n is zero**, malloc **returns a minumum-sized chunk**. (The minimum size is 16 bytes on most 32bit systems, and 24 or 32 bytes on 64bit systems.)  On most systems, size_t is an unsigned type, so calls with negative arguments are interpreted as requests for huge amounts of space, which will often fail. The maximum supported value of n differs across systems, but is in all cases less than the maximum representable value of a size_t.

也就是说在Linux上执行 malloc(0)时,会拿到一个指向一小块内存的指针,这个指针指向的内存的大小是由机器决定的。这里不再细究,有兴趣可以参考: [当你 malloc(0) 时会发生什么](https://zhuanlan.zhihu.com/p/40490357)

###### [](#1-2-realloc函数)1.2 [realloc函数](#realloc函数)

`void *realloc(void *mem_address, unsigned int newsize);`
作用:重新申请内存空间,不影响原有数据,但是新分配的地址可能不一样。

| realloc |
|---|
| 1、当mem_address为null,size不为0,则realloc()和malloc()类似。分配一个newsize的内存块,返回一个指向该内存块的指针;如果没有足够可用的内存用来完成重新分配,则返回null而原来的内存块保持不变; |  |
| 2、将分配的内存扩大,则有以下情况:(1)如果当前内存段后面有需要的内存空间,则直接扩展这段内存空间,realloc()将返回原指针;(2)如果当前内存段后面的空闲字节不够,那么就使用堆中的第一个能够满足这一要求的内存块,将目前的数据复制到新的位置,并将原来的数据块释放掉,返回新的内存块位置。(3)如果申请失败,将返回NULL,原来的指针仍然有效; |  |
| 3、如果内存减少,则仅改变下索引信息,但并不代表被减少的部分内存还可以安全访问,这己经释放; |  |
| 4、如果newsize大小为 0,行为是未定义的,受具体实现来说, 目前VC++是相当于free(ptr),并返回一个空指针,具体描述。 |  |

> 
 **If there is not enough memory**, the old memory block is not freed and null pointer is returned.

> 
 **If ptr is NULL**, the behavior is the same as calling malloc(new_size).

> 
 **If new_size is zero**, the behavior is implementation defined (null pointer may be returned (in which case the old memory block may or may not be freed), or some non-null pointer may be returned that may not be used to access storage).

 【参考文献】:
 1、[https://en.cppreference.com/w/c/memory/realloc](https://en.cppreference.com/w/c/memory/realloc)
 2、[https://en.cppreference.com/w/c/memory/malloc](https://en.cppreference.com/w/c/memory/malloc)


-------------本文结束感谢您的阅读-------------


坚持创作,坚持分享!

  
    打赏


        ![liurui 微信支付](/images/wechatpay.png)
        
微信支付


        ![liurui 支付宝](/images/alipay.png)
        
支付宝

windows下搭建python的tensorflow环境,最简单地是利用pip安装。

1. 环境准备

下载pythonsetuptoolspip. 安装python后在,将python.exe所在的路径添加到环境变量中,

1
D:\Python\Python37  假设python.exe所在的路径

pypi源上下载setuptools,下载压缩包版本的,解压之后,将setuptools拷贝到python安装路径下的tool路径下即可。

1
D:\Python\Python37\Tools  假设python的tools路径

pypi源上下载pip,下载压缩版本,解压之后,打开windows的cmd,在cmd里面cd到pip-20.1.tar.gz解压(假设是这个版本)文件所在的路径中,安装pip:python setup.py install.

2. 切换pypi源

默认的pypi源,由于服务器在国外,蜗牛一样的下载速度,试过的同学非常清楚;解决这个下载慢的问题,将默认的pypi源到国内的镜像;建议切换到阿里云的镜像,稳定快速;

pypi源 地址
清华大学 https://pypi.tuna.tsinghua.edu.cn/simple/
中国科大 https://mirrors.ustc.edu.cn/pypi/web/simple/
豆瓣 https://pypi.doubanio.com/simple/
阿里云 https://mirrors.aliyun.com/pypi/simple/

打开cmd输入set,找到USERPROFILE所在的路径,这个路径一般是用户的目录;在这个路径下创建一个pip文件夹在文件夹里面创建一个pip.ini文件,文件里面写入镜像地址。

1
2
3
[global]
trusted-host=aliyun.com
index-url=https://mirrors.aliyun.com/pypi/simple
3. 安装virtualenv虚拟化环境

会不会有人问为啥要安装虚拟化环境,这个根据个人喜好和使用习惯来定。有虚拟化环境之后可以创建多个不同的配置的环境,可以在虚拟化的环境中装各种不同场景不同配置的应用,相互不影响。linux/mac可参考:Virtualenv 的理解和使用
以管理员权限打开cmd,安装virtualenv,

  • 安装virtualenv, pip install virtualenv;

  • 在一个路径创建一个存放虚拟环境的路径,这里用了E:\python_lib这个路径

  • 用命令virtualenv web创建虚拟化环境;

  • 激活该环境,window使用cd web进入当前目录下的web中,然后用Scripts\activate激活;
    image

4. 安装tensorflow

由于笔者的pc是渣渣,这里只能安装cpu版本的tensorflow,进入想要安装的虚拟化环境之后,直接安装tensorflow

1
pip install tensorflow-cpu==2.1 指定到cpu版本的2.1版本,当然也可以不指定

image
安装完成之后进入:进入python 输入:import tensorflow as tf 看是否正常,无报错说明可以安装好了。然后就可以嗨皮的使用tensorflow了。

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. 命名空间namespace与static

namespace的是前世今生,在C语言中定义了3个层次的作用域,即文件(编译单元)、函数和复合语句。C++引入了类作用域,类是出现在文件内的。在不同的作用域中可以定义相同名字的变量,互不于扰,系统能够区别它们。全局变量的作用域是整个程序,在同一作用域中不应有两个或多个同名的实体,包括变量、函数和类等。在程序设计中,只要小心注意,可以争取不发生错误。但是,大型的应用软件,往往不是由一个人独立完成的,而是若干人合作完成的,不同的人分别完成不同的部分,最后组合成一个完整的程序。假如不同的人分别定义了类,放在不同的头文件中,在主文件(包含主函数的文件)需要用这些类时,就用#include命令行将这些头文件包含进来。由于各头文件是由不同的人设计的,有可能在不同的头文件中用了相同的名字来命名所定义的类或函数,这样就会产生命名冲突。在程序中还往往需要引用一些库(包括C++编译系统提供的库、由软件开发商提供的库或者用户自己开发的库),为此需要包含有关的头文件。如果在这些库中包含有与程序的全局实体同名的实体,或者不同的库中有相同的实体名,则在编译时就会出现名字冲突。
C 语言和早期的C++语言没有提供有效的机制来解决这个问题,没有使库的提供者能够建立自己的命名空间的工具。人们希望ANSI C++标准能够解决这个问题,提供—种机制或者工具,使由库的设计者命名的全局标识符能够和程序的全局实体名以及其他库的全局标识符区别开来。这个时候namespace就应运而生了。【namespace支持跨文件】

  • 什么是命名空间? 一个由程序设计者命名的内存区域,程序设计者可以根据需要指定一些有名字的空间域,把一些全局实体分别放在各个命名空间中,从而与其他全局实体分隔开来。

  • 命名空间的作用
    建立一些互相分隔的作用域,把一些全局实体分隔开来。

  • 命名空间的定义
    namespace ns1 {int a;double b; void fun() { //do something};}

  • 使用命名空间成员
    命名空间名::命名空间成员名,例如 std::vector

  • 命名空间的使用 (1)使用命名空间中的全部成员
    using namespace std;在本作用域(using语句所在的作用域)中引入命名空间std所有的成员的声明,以备使用;(2)使用命名空间中的特定成员;using后面的命名空间成员名必须是由命名空间限定的名字。using std::string;在本作用域(using语句所在的作用域)中引入命名空间std成员string的声明以备使用;也就是在使用了无命名namespace的文件中,使用命名空间中的成员,不必(也无法)用命名空间名限定。

  • 无名的命名空间 C++还允许使用没有名字的命名空间,由于命名空间没有名字,在其他文件中显然无法引用,它只在本文件的作用域内有效。

1.1 编译属性

在C中,给变量(局部/全局变量)、函数,加上 static表示当前函数和变量的linkage 为 internal,也就是对外部不可见, 这样就可以在不同的unit(源一般指当前文件) 中定义同名的函数和变量了。在C++中,在不同的编译unit中定义同名的函数和变量的,这样就有了命名空间namespace,解决了变量和函数名字冲突问题,同时给函数和变量限定为 internal linkage。

1.2 static 修饰的对象成员和成员函数

static修饰的对象成员不能通过调用构造函数来进行初始化,因此static修饰的数据成员必须在类外进行初始化且只会初始化一次。【静态变量内存分配在 .data段】
static修饰的成员函数为静态成员方法,静态成员方法可以在类内或类外定义,但必须在类内声明;;static成员方法没有this指针,不能直接引用非static数据成员或调用类的非static成员方法,只能调用类的static成员数据和static成员方法;static成员不是任何对象的组成,不依赖对象的调用所以static成员方法不能被声明为const,因为const只限定该类的对象;static成员方法不能同时被声明为虚函数。

参考文献:

2. 虚函数表vtbl与(虚)函数表指针vptr

虚函数表:存储虚函数信息的表; 虚函数表指针:指向虚函数表的指针。

2.1 无虚函数的类

讲C++的虚函数表之前,先看一下C语言是如何实现一个面向对象的类。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 方法1
#include
typedef struct{
int height;
int age;

void (*func)(struct* stu);
} student;
void profile(struct* stu) {printf("height:%d age:%d\n", stu.height, obj->age);}
}
int main() {
student jhon;
jhon.height = 170;
jhon.age = 20;
jhon.func = profile;
}

要有面向对象的效果,只能给struct里面添加函数指针,然后把函数赋值给指针;实际使用中这种用法比较少,主要因为函数指针的空间成本;每实例化一个结构体对象,就会有一个函数指针,例如8字节吗,如果有这个对象有m个函数指针,n个实例对象,那么消耗额外的内存是m*8*n字节。因此C语言通常不这样用,而是直接用外部定义一个函数。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// 方法2
#include
typedef struct{
int height;
int age;

} student;
void profile(struct* stu) {printf("height:%d age:%d\n", stu.height, obj->age);}
}
int main() {
student jhon;
jhon.height = 170;
jhon.age = 20;
profile(&jhon);
}

对于一个C++的类,

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
#include
class student{
public:
int height;
int age;
void profile() {printf("height:%d age:%d\n", height, age);}
} ;

}
int main() {
student jhon;
jhon.height = 170;
jhon.age = 20;
jhon.profile();
}

跟C语言实现对比,看着像第一种方式通过在结构体定义函数指针的方式来实现。但实际相当于第二种方式。为什么呢?C++中类的操作和封装只是针对程序员的,而编译器还是面向过程的,编译器会给类的成员函数添加额外的类指针参数,在运行期间传入对象实际的指针。这说明类的数据成员和成员函数是分离的。每个函数都有一个地址(指针),不论这个函数是全局函数还是类的成员函数;在类不含虚函数的情况下,编译器在编译的时候就会把函数的地址确定下来,运行期间直接去调用这个地址的函数,这就是静态绑定方式(static binding)的函数调用。

2.2 有虚函数的类

为什么会出现虚函数?为了解决面向对象中多态的实现。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
#include
class student{
public:
int height;
int age;
virtual void profile() {printf("height:%d age:%d\n", height, age);}
} ;
class seniorStu: public student{
public:
int height;
int age;
string address;
virtual void profile() {printf("height:%d age:%d\n address:%s", height, age, address.c_str());}
} ;
int main() {
student bob(185,20);
seniorStu jhon(170,25,"四川成都");
jhon.profile();
// 输出 height: 170 age:25 address:四川成都
bob.profile();
// 输出 height: 185 age:20
student* jim = &jhon;
jim->profile();
// 输出 height: 170 age:25
student& tom = &jhon;
tom.profile();
// 输出 height: 170 age:25
return 0;
}

上述,可以看到用父类指针指向子类的地址,最终调用的profile函数韩式子类的
这个现象称之为动态绑定(dynamic binding)后者说延迟绑定(lazy binding)。这里如果把子类的virtual,这个代码将调用父类的profile,输出:

输出 height: 170 age:25

输出 height: 170 age:25

这是由于类的数据成员和函数成员是分离的

2.3 虚表指针和虚函数表

从内存布局上,只能看到成员变量,看不到成员函数。因为在编译的时候就确定调用哪个函数。
将了这么多,可以回归到整体函数虚函数表了,也就是C++多态的实现。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
#include
#include
class student{
public:
int height;
int age;
virtual void profile() { printf("height:%d age:%d\n", height, age);}
virtual void status() { std::coutprofile();
// 输出 height: 170 age:25
student& tom = &jhon;
tom.profile();
// 输出 height: 170 age:25
return 0;
}

这个示例父类有两个虚函数,子类重载了这两个虚函数。查看编译器的内存布局,
clang有个命令可以输出对象的内存布局(不同编译器内存布局未必相同),

clang -cc1 -fdump-record-layouts -stdlib=libc++ student.cpp

可以看到类似于这样的内存分布:

1
2
3
4
5
6
7
8
9
10
11
12
13
*** Dumping AST Record Layout
0 | class student
0 | (student vtable pointer)
x | int height
x | int age

*** Dumping AST Record Layout
0 | class seniorStu
0 | class student (primary base)
0 | (student vtable pointer)
x | int height
x | int age
x | string status

在父类student的起始位置有一个student vtable pointer;子类seniorStu是在他的基础上多了自己的成员status。对于含有虚函数的类,在编译期间编译器会给这种类自动的在起始位置添加一个虚表指针(vptr),让虚表指针vptr指向一个虚表;虚表中存储了实际的函数地址。那么虚表里面存储了那些详细的内容呢? g++有打印虚表的操作(请在Linux上使用g++)会自动写到一个文件里:

g++ -fdump-class-hierarchy student.cpp

可以看出如果vptr指向的并不是虚表的表头而是表头加偏移量而获得一个地址,也就是虚函数的位置。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
Vtable for student
student::_ZTV7student: 4u entries
0 (int (*)(...))0
8 (int (*)(...))(& _ZTI7student)
16 (int (*)(...))student::profile
24 (int (*)(...))student::status

Class student
size=24 align=8
base size=20 base align=8
student (0x0x7f9b1fa8c960) 0
vptr=((& student::_ZTV7Actress) + 16u)

Vtable for Sensei
seniorStu::_ZTV6seniorStu: 4u entries
0 (int (*)(...))0
8 (int (*)(...))(& _ZTI6seniorStu)
16 (int (*)(...))seniorStu::profile
24 (int (*)(...))seniorStu::status

Class seniorStu
size=24 align=8
base size=24 base align=8
seniorStu (0x0x7f9b1fa81138) 0
vptr=((& seniorStu::_ZTV6seniorStu) + 16u)
student (0x0x7f9b1fa8c9c0) 0
primary-for seniorStu (0x0x7f9b1fa81138)
2.4 总结一下

1、如果一个类中有一个虚函数,这个类就有一个虚函数表。虚函数表示类的,而不是属于对象的,在编译时就确定了,存放在只读的数据段(非代码段)。每实例化一个类对象都有一个虚函数表指针,指向类的虚函数。虚函数表指针属于类的对象。存放在堆上或者栈上(什么时候存放在堆,什么时候存放在栈上需要再探讨一下)。2、对于有派生子类的情况:如果基类有虚函数,不管派生类实现或者没有虚函数,都有虚函数表。基类的虚函数表和派生类的虚函数表不是同一个表。如果派生类没有重写基类的函数,则派生类的虚函数表和基类的虚函数表内容是一样的。如果派生类重写了基类的虚函数,则培生累的虚函数表中用的是派生类的函数。3、对于多继承的情况,含有虚函数的基类有多少个,派生类就有多少个虚函数表;派生类有的而基类没有的,添加在派生类的第一个虚函数表中,虚函数表的结果是*表示还有下一个虚函数表,结果是0表示是最后一个虚函数表。

参考文献:

3. C/C++的内存分布
内存区 用途 申请释放方式
栈区 存储局部和临时变量,函数调用时存储函数调用时,存储函数的返回指针用于控制函数的调用和返回 程序开始是自动分配内存,结束自动释放
堆区 存储动态内存分配 程序员手动申请,手动释放;若程序员不释放,在程序结束是,系统回收
BSS段 存储未初始化的变量数据,包括初始化为0的全局变量 只占运行时内存空间不占文件空间。在程序整个周期内,BSS段的数据一致存在
data区 存储已经初始化的变量数据,为数据分配空间,数据保存在目标文件中 —–
代码段TXT 存储程序代码的内存映射,以及函数体的二进制代码 —–
文字(只读)常量区 存字符串常量放等 程序结束后有系统释放
全局区(静态区) 全局变量和静态变量存储在一起,未初始化或者初始化为0的存在BSS,初始化不为0的全局变量或者静态变量存在此处 程序结束后由系统释放

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. 什么是状态模式

  状态模式是一种行为型的设计模式,由一个场景类context驱动;所有的状态都通过state类继承过来。表现为如图1所示的样子。
image图1 状态模式类图
  状态模式允许通过改变对象内部的状态而改变对象的行为,整个对象表现得就好像修改了它的类一样。状态模式的每个状态子类中需要包含环境类(Context)中的所有方法的具体实现——条件语句。通过把行为和行为对应的逻辑包装到状态类里,在环境类里消除大量的逻辑判断,而不同状态的切换由继承(实现)State的状态子类去实现,当发现修改的当前对象的状态不是自己这个状态所对应的参数,则各个状态子类自己给Context类切换状态, 客户端不直接和状态类交互,客户端不需要了解状态。

2. 状态模式的实现
案例1:开灯关灯

  灯有两种状态,开和关,非开即关。开和关组成一个状态机;状态的变迁由前一个状态的变化触发,可以理解为触发器。定义一个定义一个State类抽象灯的开和关;

1
2
3
4
5
6
class state {
public:
virtual void turnLightOn() {};
virtual void turnLightOff() {};
virtual ~state() {};
};

  对应开和关分别定义两个类onState和offState:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
class offState : public state {
public:
offState() { }
~offState() {}

void turnLightOn() {cout stateMap;
public:
context() //state* offSte,state* onSte
{
offSte = new offState();
onSte = new onState();
currentType = offSte;
}
~context()
{
delete offSte;
delete onSte;
}

void turnOnLight()//开灯
{
currentType->turnLightOn();
currentType = onSte;
}
void turnOffLight()//关灯
{
currentType->turnLightOff();
currentType = offSte;
}
};

  这样就完成了由两个状态组成的状态模式;用main.cpp实现充当client;

1
2
3
4
5
6
7
8
9
10
11
#include"context.h"
int main()
{
context myContext =context();

myContext.turnOnLight();
myContext.turnOffLight();
return 0;
}

  看一下通过上下文请求:这个与上述任何状态都没有直接连接;默认状态为关着灯,初始请求开灯,灯的状态变为ON,灯着开;第二个请求是一样的,它只输出一条消息状态并不做改变,指示正处于当前请求的状态什么也不发生。以下显示了这些请求的结果:
输出结果为:

1
2
3
4
灯开了,可以开始干活了!
灯已经开了,不用再开了!
灯关了,可以休息了!
灯已经关了,快点休息吧!
案例2:有三级亮度的灯

  在正常开灯关灯的基础上增加两种状态,比如灯更亮,灯最亮的状态;按照状态模式的设计定义,我们就需要再增加两个类,分别表示更亮和最亮。相应的类的接口就需要增加一个接口;现在的状态变迁过程就是:关->亮->更亮->最亮,状态之间是单线的传递变迁。由于状态类的变迁是单向的,这里我们重构以状态类,通过turnLightSwitch()方法触发状态的变迁。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
class state {
public:
virtual void turnLightSwitch() {};
virtual ~state() {};
};

class offState : public state {
public:
offState() { }
~offState() {}

void turnLightSwitch()
{
cout turnLightSwitch();
return;
}
cout turnLightSwitch();
return;
}
cout turnLightSwitch();
return;
}
cout turnLightSwitch();
return;
}
cout up();}
void down() {currentState->down();}
void left() {currentState->left();}
void right(){currentState->right();}
};
3. 状态模式优劣

优点: 1、封装了转换规则。 2、枚举可能的状态,在枚举状态之前需要确定状态种类。 3、将所有与某个状态有关的行为放到一个类中,并且可以方便地增加新的状态,只需要改变对象状态即可改变对象的行为。4、允许状态转换逻辑与状态对象合成一体,而不是某一个巨大的条件语句块。 5、可以让多个环境对象共享一个状态对象,从而减少系统中对象的个数。

缺点: 1、状态模式的使用必然会增加系统类和对象的个数。 2、状态模式的结构与实现都较为复杂,如果使用不当将导致程序结构和代码的混乱。 3、状态模式对”开闭原则”的支持并不太好,对于可以切换状态的状态模式,增加新的状态类需要修改那些负责状态转换的源代码,否则无法切换到新增状态,而且修改某个状态类的行为也需修改对应类的源代码。

使用场景: 1、行为随状态改变而改变的场景。 2、条件、分支语句的代替者。

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

以数组和字符串形式的例题总结,涉及到排列和组合相关问题的,主要通过递归或者循环解决问题。

1. 组合问题

【从n个元素中取m个元素–子集】
例题1. LeetCode-78-子集

给定一组不含重复元素的整数数组 nums,返回该数组所有可能的子集(幂集)。
说明:解集不能包含重复的子集。
示例:
输入: nums = [1,2,3]
输出: [[3],[1],[2],[1,2,3],[1,3],[2,3],[1,2],[] ]

题解:从数组中连续至少0个元素,构成的子集问题,可以模拟成一个层次遍历的过程;从空集合开始,然后空集合的基础上依次插入元素,先是1个元素的集合,接着是2个元素的集合,依次类推。
首先,创建一个局部变量存放结果,把空集合插入存进去vector<vector<int> > res(1);遍历整个数组,同事嵌套遍历结果数组,往结果数组中依次插入当前遍历到的数组元素,由于结果数组中有一个空子集,嵌套遍历结果数组的时候,就是往空子集中插入第1个元素,此时这个结果肯定是没有出现的排列,再把这个排列插入结果数组;这样结果中就存入了[]和[1];此时进去下一次迭代,数组的第二个元组,在依次往结果数组中的子集插入,也就是[2]依次插入[]和[1]中;以此类推,就可以遍历完所有的排列。

1
2
3
4
5
6
7
8
9
10
/**代码实现**/
vector> subsets(vector& nums) {
vector > res(1);
for(int i=0;i tmp=res[j];
tmp.push_back(nums[i]);
res.push_back(tmp);
}
}
return res;
}

例题2. LeetCode-90-子集II

给定一个可能包含重复元素的整数数组 nums,返回该数组所有可能的子集(幂集)。
说明:解集不能包含重复的子集。
示例:
输入: [1,2,2]
输出: [[2],[1],[1,2,2],[2,2],[1,2],[]]

题解 题目中描述有重复元素,所以去重是在排列里面很关键,在上一题的基础上增加去重的操作即可,这里用一个set去去重,由于排列不考虑数的顺序,所以需要排序一下,进行归一化,然后设计一个hash表去重,这里hash表示就是unordered_map,键值用排序后的数组字符化表示;

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
string clcHashValue(vector& nums){
string res = "";
sort(nums.begin(),nums.end());
for(int i=0; i > subsetsWithDup(vector& nums) {
vector > res(1);
unordered_set numstt;
for(int i=0;i tmp=res[j];
tmp.push_back(nums[i]);
string tempHash = clcHashValue(tmp);
if(numstt.find(tempHash) == numstt.end()){
res.push_back(tmp);
numstt.insert(tempHash);
}
}
}
return res;
}
2. 排列问题

例题1. 面试题 08.07. 无重复字符串的排列组合

无重复字符串的排列组合。编写一种方法,计算某字符串的所有排列组合,字符串每个字符均不相同。
示例1:
输入:S = “qwe”
输出:[“qwe”,”qew”,”wqe”,”weq”,”ewq”,”eqw”]
示例2:
输入:S = “ab”
输出:[“ab”,”ba”]

题解 我们把字符串看成两部分,第一部分是它的第一个字符,第二部分是后边的字符。求整个字符串的排列,可以就可以看成两部分,首先求所有可能出现在第一个位置的字符,也就是把第一个字符和后边所有的字符交换。第二部分固定第一个字符求后面字符的排列。在第二部分的时候仍把后边的字符分成2部分,依次类推。这样就是很典型的递归了。

1
2
3
4
5
6
7
8
9
10
11
12
13
void strPerm(vector &result, string &s, int beginIndex) {
if(beginIndex == s.size()-1) {
result.push_back(s);
return;
}
for(int i = beginIndex; i permutation(string s) {
vector result;
if(s.empty()) {
return result;
}
strPerm(result, s, 0);
return result;
}

例题2. 面试题 08.08. 有重复字符串的排列组合

有重复字符串的排列组合。编写一种方法,计算某字符串的所有排列组合。
示例1: 输入:S = “qqe” 输出:[“eqq”,”qeq”,”qqe”]
示例2: 输入:S = “ab” 输出:[“ab”, “ba”]
提示: 字符都是英文字母。字符串长度在[1, 9]之间。

题解 如上题一样,这里主要去重,去重,可以简单地额用一个hash表来解决,这里用unordered_set来创建hash。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
void strPermu(unordered_set& perLib, vector& res, string &s, int beginIndex) {
if(s.size()-1 == beginIndex) {
if(perLib.find(s)==perLib.end()) {
res.push_back(s);
perLib.insert(s);
}

return;
}
for(int i = beginIndex; i permutation(string s) {
vector result;
if(s.empty()) {return result;}
unordered_set perLib;
strPermu(perLib, result, s, 0);
return result;
}

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

字符串的子串子序列子串必须是连续的子序列不一定要求联系什么叫回文串?如果一个字符串正着读和反着读是一样的,那它就是回文串

1. 最长回文串

例题1. 409. 最长回文串

给定一个包含大写字母和小写字母的字符串,找到通过这些字母构造成的最长的回文串。
在构造过程中,请注意区分大小写。比如 “Aa” 不能当做一个回文字符串。

  • 注意:
    假设字符串的长度不会超过 1010。
    示例 1:
    输入:b “abccccdd”
    输出: 7
  • 解释: 我们可以构造的最长的回文串是”dccaccd”, 它的长度是 7。

题解: 给一个字符串,要求这个字符串的字符能构成的最长回文字符串,建立一个hash统计每个字符的数量,然后遍历hash表,如果字符的个数是偶数,则将这些偶数的字符个数加起来;然后将字符数是奇数的依次减去1,同事统计奇数的个数在奇数>0的时候在累加和上+1,否则+0,得到的结果就是答案可以构成的最长回文字符串。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public:
int longestPalindrome(string s) {
if(s.size() charLibHash;
for(auto & ch: s){
charLibHash[ch]++;
}
int oddNum = 0;
int evenNum = 0;
for(auto itr = charLibHash.begin(); itr!=charLibHash.end();itr++) {
if(itr->second%2 == 0){evenNum+=itr->second;}
else{
if( itr->second>0 ) {
evenNum+=itr->second-1;
}
oddNum++;
}
}
return evenNum+(oddNum>0?1:0);
}
};

例题2. 5.最长回文子串

给定一个字符串 s,找到 s 中最长的回文子串。你可以假设 s 的最大长度为 1000。

  • 示例 1:
    输入: “babad”
    输出: “bab”
    注意: “aba” 也是一个有效答案。
  • 示例 2:
    输入: “cbbd”
    输出: “bb”

题解: 方法1 字符串正着读和反着读是一样的,也就是从从回文中心两边互为镜像。因此以中心展开,只有两种可能,1是回文字符串是奇数长度,2是偶数长度;对于 n 长度的字符串,不知道它的回文串中心倒底是奇数数还是偶数,所以我们要对这两种情况都做遍历,也就是 n+(n-1) = 2n - 1,所以时间复杂度为 O(n);当中心确定后,我们要围绕这个中心来扩展回文,那么最长的回文可能是整个字符串,所以时间复杂度为 O(n);所以依次遍历字符串,时间复杂度为 O(n^2)。

1
2
3
4
5
6
7
8
9
10
11
class Solution {
public:
int palindromeLen(string& s, int beginIndex, int endIndex) {
while(beginIndex>=0 && endIndex endIndex - beginIndex){
beginIndex = i - (circleLen - 1) / 2;
endIndex = i + circleLen/2;
}
}
return s.substr(beginIndex, endIndex-beginIndex+1);
}
};

方法2 暴力法,暴力法将选出所有子字符串可能的开始和结束位置,并检验它是不是回文。假设 n 是输入字符串的长度,从字符串头尾开始依次截取字符串,检查是否为回文字符串。从头一遍循环,尾部一次遍历,中间检查是否是回文再一次遍历,因为验证每个子字符串需要 O(n)O(n) 的时间,所以运行时间复杂度是 O(n^3)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public:
string longestPalindrome(string s) {
if (s.size() = 0; i--) {
int copyIndexI = i;
string tempStr;
if (result.size() >= i+1) { // s.substr(0, i + 1).size()
break;
}
for (int j = 0; j result.size() ? tempStr : result;
}
}
}
if (s.size() > 1 && result.empty()) { return s.substr(0, 1); }
return result;
}
};

例题3. 214. 最短回文串

给定一个字符串 s,你可以通过在字符串前面添加字符将其转换为回文串。找到并返回可以用这种方式转换的最短回文串。

  • 示例 1:
    输入: “aacecaaa”
    输出: “aaacecaaa”
  • 示例 2:
    输入: “abcd”
    输出: “dcbabcd”

题解: 题目要求从字符串开始添加字符,形成的最短回文字符串。方法1:暴力法:首先检查字符是不是回文字符串,如果是直接返回,若不是则依次从末尾删除字符串,每删除一个检查一遍当前字符串是否是回文字符串,如果是就将删除的字符串添加到字符串开头;否则继续重复删除和检查的动作,直至删掉n-1个字符;

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution {
public:
int iSpaliStr(string& s, int beginIndex, int endIndex){
while(beginIndex 0 ; endIndex--) {
if(iSpaliStr(s, 0, endIndex) == true) {
break;
}
}
string temp = s.substr(endIndex+1, s.size() - endIndex-1);
// 或者取s.substr(endIndex+1); 取endIndex+1至字符串结尾的子串。
reverse(temp.begin(), temp.end());
return temp+s;

}
};

方法2:暴力升级版: 寻找从开头开始的最长回文串,然后将末尾的除去最长回文串部分的几个字符倒置后加到原字符串开头即可。将原始字符串逆序,然后比较对应的子串即可判断是否是回文串。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
**举例**
abbacd
原s: abbacd, 长度记为 n
逆r: dcabba, 长度记为 n
判断 s[0,n) 和 r[0,n)
abbacd != dcabba
判断 s[0,n - 1) 和 r[1,n)
abbac != cabba
判断 s[0,n - 2) 和 r[2,n)
abba == abba
从开头开始的最长回文串也就找到了, 接下来只需要使用之前的方法。
将末尾不是回文串的部分倒置加到原字符串开头即可。

class Solution {
public:
string shortestPalindrome(string s) {
if(s.empty()) {return s;}

string str = s;
reverse(str.begin(), str.end());
int index = 0;
int len = s.size();
for(;index两个字母相同
cell[i][j] = cell[i-1][j-1]+1
else:
cell[i][j] = 0

== 公共子序列 ==
if word_a[i] == word_b[j]: --->两个字母相同
cell[i][j] = cell[i-1][j-1]+1
else:
cell[i][j] = max(cell[i-1][j], cell[i][j-1])

例题1. 516. 最长回文子序列

给定一个字符串s,找到其中最长的回文子序列。可以假设s的最大长度为1000。

  • 示例 1:
    输入:
    “bbbab”
    输出:
    4
    一个可能的最长回文子序列为 “bbbb”。
  • 示例 2:
    输入: “cbbd”
    输出: 2
    一个可能的最长回文子序列为 “bb”。

题解: 求字符串的最长回文序列,理解一下回文,就是正反念都一样,那么把字符串颠倒一下,求回文子序列就相当于求字符串和它的翻转字符串公共子序列。用动态规划求解,

  • 状态:f[i][j] 表示 s 的第 i 个字符到第 j个字符组成的子串中,最长的回文序列长度是多少;

  • 转移方程
    如果 s 的第 i 个字符和第 j 个字符相同的话
    dp[i][j] = dp[i + 1][j - 1] + 2
    如果 s 的第 i 个字符和第 j 个字符不同的话
    dp[i][j] = max(dp[i + 1][j], dp[i][j - 1]);

参考方法
[1]. https://leetcode-cn.com/problems/longest-palindromic-subsequence/solution/dong-tai-gui-hua-si-yao-su-by-a380922457-3/
[2]. https://leetcode-cn.com/problems/longest-palindromic-subsequence/solution/jian-dan-zhi-jie-de-dong-tai-gui-hua-by-ha-di-2/

1
2
3
4
5
6
7
8
9
10
class Solution {
public:
int longCommStr(vector>& dp, string& str1, string& str2) {
for(int i = 1; i >& dp, int Len){
for(int i = 0; i> dynamicsp(s.size()+1, vector(s.size()+1));
initDpArr(dynamicsp, s.size());

return longCommStr(dynamicsp, s, str);
}
};

例题2. 1143. 最长公共子序列

给定两个字符串 text1 和 text2,返回这两个字符串的最长公共子序列。
一个字符串的 子序列 是指这样一个新的字符串:它是由原字符串在不改变字符的相对顺序的情况下删除某些字符(也可以不删除任何字符)后组成的新字符串。
例如,”ace” 是 “abcde” 的子序列,但 “aec” 不是 “abcde” 的子序列。两个字符串的「公共子序列」是这两个字符串所共同拥有的子序列。
若这两个字符串没有公共子序列,则返回 0。

  • 示例 1:
    输入:text1 = “abcde”, text2 = “ace”
    输出:3
    解释:最长公共子序列是 “ace”,它的长度为 3。
  • 示例 2
    输入:text1 = “abc”, text2 = “abc”
    输出:3
    解释:最长公共子序列是 “abc”,它的长度为 3。
  • 示例 3:
    输入:text1 = “abc”, text2 = “def”
    输出:0
    解释:两个字符串没有公共子序列,返回 0。
  • 提示:
    1 <= text1.length <= 1000
    1 <= text2.length <= 1000
    输入的字符串只含有小写英文字符。

题解: 动态规划,直观遍历

1
2
3
4
5
6
7
8
class Solution {
public:
int longCommStr(vector>& dp, string& str1, string& str2) {
for(int i = 1; i >& dp, int Len){
for(int i = 0; i> dynamicsp(text1.size()+1, vector(text2.size()+1));
return longCommStr(dynamicsp, text1, text2);
}
};

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1. 什么是函数指针

指针函数
指针函数本质是一个函数,只不过返回值为某一类型的指针(地址值)。函数返回值必须用同类型的变量来接受,也就是说,指针函数的返回值必须赋值给同类型的指针变量。
函数指针
函数指针本质是一个指针,只不过这个指针指向一个函数。指针变量通畅指向一个整形、字符型、或者数组等变量,而函数指针指向的是函数。
常见的函数都有其入口,比如 main() 函数是整个程序的入口,我们调用的其他函数都有其特定的入口,正如我们可以通过地址找到相应的变量一样,我们也可以通过地址找到相应的函数。而这个存储着函数地址的指针就是函数指针。可以通过指针访问相应的变量,函数指针也可以像函数一样用于调用函数、传递参数。
回调函数
函数指针作为某个函数的参数。理解回调函数,我们先要搞清楚回调函数有什么作用。比如老板、经理、你三个角色。老板通常是规则的指定着,经理按照规则指派相应的人去做事,而你就是任务的具体执行者。当老板要求经理去做一个事情,那么老板就是主调函数,经理就是回调函数,你按照规则去处理事情就是相应回调函数。你处理的结果会反馈给经理,经理拿着你的结果再反馈给老板。老板就可以使用这个结果去做相关的事情了。在这个环节中,你只需要按照指定的规则去做事,而经理不需要考虑事情是怎么做的,他只需要把相应的事情分配给对应的人去处理即可,然后将获取的结果反馈给老板。如果规则有变,只需要对应的员工知道哪里改变了,而经理不需要关注这些细节。
函数指针的应用场景

  • 普通的函数指针,指向函数,实现比如勾子函数等

  • 回调函数,实现在特定情况下需要不同的处理,或者对不同些数据的不同处理

  • 封装,函数模板,构造对象(类似于C++虚函数)等等

结构体,是定义了一个用户自定义内型,那么这个内型就可以定义N多的变量,不同的变量拥有不同的值,也包括函数指针的值,这样就实现了”多态”,模拟OOP中的虚函数。
函数指针声明 函数原型int sum(int,int);是一个返回值为int类型, 参数是两个int类型的函数. 如何声明该类型函数的指针呢?将函数名替换成(*pf)形式即可,即我们把sum替换成(*fp)即可,fp为函数指针名int (*fp)(int,int); 这样就声明了和sum函数类型相同的函数指针fp, *和fp为一体,说明了fp为指针类型; *fp需要用括号括起来,否则就会变成int *fp(int,int);,这时候意义就变化了,成立一个返回值为一个int指针类型的函数,函数一个函数指针。为了避免每次声明函数指针的时候方便,函数指针可以用typedef定义:

1
2
typedef int (*myFun)(int,int);//为该函数指针起一个新名字
myFun f1; //声明myFun类型的函数指针f1

函数指针赋值

1
2
3
4
5
6
7
8
9
10
11
12
13
14
#include
int mytest(int a,int b)
{
return a+b;
}
typedef int(*fp)(int,int);
int main(void)
{
fp func1 = mytest; //表达式1
fp func2 = &mytest;//表达式2
printf("%d\n",func1);
printf("%d\n",func2);
return 0;
}

这里,声明返回类型为int,接受两个int类型参数的函数指针func1和func2,分别给它们进行了赋值。表达式1和表达式2在作用上是一样的。由于函数名在被使用时总是由编译器把它转换为函数指针,因此前面加上&只是显式的说明了这一点而已。

函数指针的调用

1
2
3
4
5
6
7
8
9
10
11
12
13
#include
int mytest(int a,int b)
{
return a+b;
}
typedef int(*fp)(int,int);
int main(void)
{
fp func = mytest; //表达式1
func(1,2); //表达式1
(*func)(3,4); //表达式2
return 0;
}

在函数指针后面加括号,并传入参数即可调用,其中表达式1和表达式2似乎都可以成功调用,但是哪个是正确的呢?ANSI C认为这两种形式等价。

2. 函数指针的用途

1、作为句柄函数传入,
以库函数qsort排序函数为例,

1
void qsort(void *base,size_t nmemb,size_t size , int(*compar)(const void *,const void *));

拆开来看如下:

1
void qsort(void *base, size_t nmemb, size_t size, );

拿掉第四个参数后,它是一个无返回值的函数,接受4个参数,第一个是void*类型,代表原始数组,第二个是size_t类型,代表数据数量,第三个是size_t类型,代表单个数据占用空间大小,而第四个参数是函数指针。这第四个参数,即函数指针指向的是什么类型呢?

1
int(*compar)(const void *,const void *)

这是一个接受两个const void*类型入参,返回值为int的函数指针。
这个参数告诉qsort,应该使用哪个函数来比较元素,即只要我们告诉qsort比较大小的规则,就可以帮我们对任意数据类型的数组进行排序。

结构体中包含函数指针,可以像一般变量一样,包含函数指针变量.下面是一种简单的实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
struct opt  
{
int x,y;
int (*func)(int,int); //函数指针
};
void main()
{
struct opt demo;
demo.func=add2; //结构体函数指针赋值
//demo.func=&add2; //结构体函数指针赋值
printf("func(3,4)=%d\n",opt.func(3,4));
demo.func=add1;
printf("func(3,4)=%d\n",opt.func(3,4));
}

C语言中的struct是最接近类的概念,但是在C语言的struct中只有成员,不能有函数,但是可以有指向函数的指针,们使用函数。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
typedef struct student  
{
int id;
char name[50];
void (*init)();
void (*process)(int id, char *name);
void (*destroy)();
}stu;

void init() { /*do something*/ }
void process(int id, char *name) { /*do something*/ }
void destroy() { /*do something*/ }

int main()
{
stu *stu1 = (stu *)malloc(sizeof(stu));
stu1->id=1000;
strcpy(stu1->name,"C++");
stu1->init=init;
stu1->process=process;
stu1->destroy=destroy;
printf("%d\t%s\n",stu1->id,stu1->name);
stu1->init();
stu1->process(stu1->id, stu1->name);
stu1->destroy();
free(stu1);
return 0;
}
3. 函数指针的面向对象应用

函数指针是解耦对象关系的最佳利器。

3.1 命令模式

命令模式通过增加中转数据结构,使命令下达和命令执行二者依赖于接口,从而达到二者时间上不相关、二者变化方向独立的目的。
【好处:代码清晰明了,容易添加和删除,易维护】

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
typedef struct {
uint8_t cmd;
void (* handle)(char *buffer);
} package;

static const package packageItems[] =
{
{0x01, parse_temperature},
{0x02, parse_humidity},
{0x03, parse_illumination},
{0xFF, NULL},
};
static uint8_t parse(void *buffer, uint16_t length)
{
package *frame = (package *)buffer;
if (frame == NULL) { // 异常处理 }

const package *entry;
for (entry = packageItems; entry->handle != NULL; ++entry) {
if(frame->cmd == entry->cmd) {
entry->handle(frame->data);
break;
}
}
}

什么时候会用到这个命令模式呢?

  • 按键处理

  • 协议解析(串口,网口,CAN,等等)

3.2 策略模式
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
//开关配置过程
typedef void (*ProcStrategy)();
ProcStrategy procStrategy;
if (strategy == A)
{
procStrategy = ProcStrategyA;
}
else
{
procStrategy = ProcStaregyB;
}

//核心逻辑处理过程
...
procStrategy();
...
3.3 观察者模式

函数需要抽象出来一个action函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
void Eat() { // do something}
void Drink() { // do something}
void Rest() { // do something}

typedef void (*lAction)();
lAction flikuiAction[3] = {Eat, Drink, Rest};

//命令响应程序
void DoCmd(Cmd *cmd)
{
for(int i = 0; i cmdNum; i++)
{
flikuiAction[cmd->cmd[i]]();
}
}
3.4 状态模式

有这么一个需求,宋江命令李逵杀敌,李逵此时有很多种状态,李逵要根据自己不同的状态做出不同的反应:如果正在吃饭,就扔掉碗进入空闲态,如果处于空闲,就拿起斧子进入战斗状态,如果处于战斗状态,就不做响应。

1
2
3
4
5
6
7
8
9
10
11
12
13
typedef void (*LikuiDoAction)();

LikuiDoAction likuiDoAction[3][3] =
{ /* EATING */ /* FIGHTING */ /* IDLE */
/* EAT */ {DoNothing, ThrowAxe, TakeBowl},
/* FIGHT */ {ThrowBowl, DoNothing, TakeAxe},
/* IDLE */ {ThrowBowl, ThrowAxe, DoNothing}
}

void LikuiAction()
{
likuiDoAction[SongjiangCmd][LikuiStatus]();
}
4. 函数指针与函数调用的性能分析

直观上看应该是函数调用开销更小。函数指针调用方案中需要先访问数据区,再访问函数,增加指令开销,同时,数据取值与函数指令加载必须串行执行,影响CPU流水性能;函数调用方案可以做内联优化。

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1、Python

1)Python_交互式的学习资源
2)Python生成动态图表
3)Python文章中精选Top10
4)忘了Python关键语句?这份备忘录拯救你的记忆
5)Python教程:17个冷门但实用的小技巧

2、机器学习相关

1)通俗理解PCA降维作用
2)18年9月机器学习开源项目Top10
3)LSTM和GRU的解析
4)算法和编程面试题精选TOP50
5)5种回归损失函数
6)精选机器学习文章Top10
7)如何通过引入硬注意力机制来学习视觉问答任务?
8)深度学习必备数学知识之线性代数篇
9)构建深度神经网络的实用技巧
10)ICML2018见闻 | 迁移学习、多任务学习领域的进展
11)8 个超赞的深度学习课程
12)合成注意力推理神经网络-Christopher Manning-ICLR2018
13)李宏毅-201806-中文-Deep Reinforcement Learning精品课程  提取码:3eig
14)最新深度学习面试题目及答案集锦
15)MIT 6.S094 深度学习与自动驾驶课程(下)
16)迁移学习在自然语言处理中的应用之通用语言建模
17)图说卡尔曼滤波_一份通俗易懂的教程
18))面试了10家公司,以下是一份机器学习面试内容总结
19)献给新手的深度学习综述 | 入门
20)https://zhuanlan.zhihu.com/p/46396329

3、Git相关

1)泪流满面的 11 个 Git 面试题

4、图像处理&计算机视觉

1)从R-CNN到RFBNet,目标检测架构5年演进全盘点
2)CNN图像分割简史:从R-CNN到Mask
3)图像超级补全效果惊艳(附代码)
4)用神经网络操纵图像中的自然场景属性

5、文本相关

1、基于深度学习的文本分类6大算法
2、Scene Text Detection

6、hexo相关

1)hexo命令 https://hexo.io/zh-cn/docs/commands.html

Others

脉冲神经网络(SNN)

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

1980年,心理学家William James出版了第一部论述人脑结构及功能的专著《心理学原理》,首次提出:

“一个神经细胞受到刺激激活后可以把刺激传播到另一个神经细胞,并且神经细胞激活是所有细胞输入叠加的结果!”

为人们认识神经网络的活动打开了理论的天窗。基于这个理论假设,从1943年开始,神经网络经历的曲折荡漾的发展,经历了数次的大起大落;理论模型也从单一的神经元感知机开始,发展到包含一个隐藏的多层感知机网络,到现在已卷积神经网络为代表的深度卷积神经网络。
  本文以神经网络的发展为线索,从卷积神经网络的结构和应用两个方面进行简单阐述。

1. 什么是卷积神经网络

  认识卷积神经网络之前首先要了解两个基本的概念: 1、什么是卷积;2、什么是神经网络。

1.1 什么是卷积
  • 从图像的角度来看卷积: 就是卷积模板在图像上滑动,把对应位置上的元素相城相加得到最终结果的过程。如果考虑翻转则就需要翻转卷积模板。

  卷积核的大小是奇数,如3x3,5x5,7x7等;在cnn的世界里,卷积就是通过不同的卷积核,在不同的图像尺度下,滑动来计算卷积特征的。通过修改卷积核的参数,可以实现对图像进行锐化、模糊等操作,从而检测出图像中的视觉特征;训练cnn的过程,其实也是学习这些卷积和参数的过程。在有限的范围内,使用的卷积核越多,可以学习到的图像特征也就越多。

1.2 什么是神经网络

   按照William James的观点,人工神经网络是基于神经元假设的一种数学描述,是从信息处理的角度将人脑神经元网络进行抽象,从而建立某种模型,可以让神经元按照不同的连接方式组成不同网络的一种数学方法。神经元由大量的节点连接,这个节点称之为激活函数。常见的激活函有: sigmoidtanhRelu;

$$
\begin{eqnarray}
Sigmoid(x) = 1/(1+e^{-x}) \
tanh(x)=\frac{1-e^{-2x}} {1+e^{-2x}} \
relu(x)=max(0,x)
\end{eqnarray}
$$

三种常用的激活函数 三种常用的激活函数
  而神经元数学模型就是输入向量X经过加权,通过激活函数f过滤,输出y,也就是:

$$
\begin{equation}
y=f(w_1x_1+w_2x_2+b)
\end{equation}
$$

这就是感知机的数学表达。$f(x)$但是它只能解决线性问题,对于非线性问题,感知机就无从下手了,比如:异或问题。为了解决非线性问题,又在感知机的基础上提出了前馈神经网络多层感知机 ;如图,给定一组特性向量:
$$x=(x_1, x_2, x_3, ….)$$ 通过输入层输入到MLP网络,网络中的隐藏层,相对于增加感知机的决策平面,从而引入多个决策节点,通过级联这些神经元,就可以将原本单个感知机的线性表示表示成多个分段的线性表示,这样就将线性的问题转换成了非线性。也就是无线逼近的积分结果,这样就可以将学习特征用级联的线性表达学习复杂的非线性模式。

1.3 什么是卷积神经网络

  卷积区别于传统的前馈神经网络的重要是,多层感知机表达的前馈神经网络的每个神经元都和前一层的输入全部相连接,是一种完全连接的模式;而卷积神经网络通过卷积核与前一层的输入相连接,卷积核的尺寸(感受野)就是卷积神经网络的连接范围,是一种局部的连接的方式。
全连接与局部连接
  上图中,假设输入图像是一个1000*1000的图像,左边全连接的网络有100w个隐层的神经元,每个神经元都与输入图像的每个像素相连,那么这个网络就有1000*1000*100w = 10^12个连接;右边局部连接的网络每个节点与输入图像有10*10(实际连接的卷积和尺寸是奇数)的连接,那么100w个隐层的神经元的连接个数是10*10*100w = 10^8,比全连接少了4个数量级。除此之外卷积神经网络还有另外一个特新就是权值共享。也就是在同一层的卷积核对应的参数是相同卷积核。
卷积
  上图是一个卷积的示例,左边红色为32*32*3的输入数据,蓝色部分是一层卷积网络;右边为卷积网络的神经元数学表述,是和普通的前馈神经网络相同的模型;除了卷积和全连接的区别,卷积神经网络结构也差别很大,是由卷积核的宽度、高度和卷积层数表述的一种长、宽、深度的三维模型,这里的深度就是卷积神经网络的网络层数;

1.3 卷积神经网络的基本结构

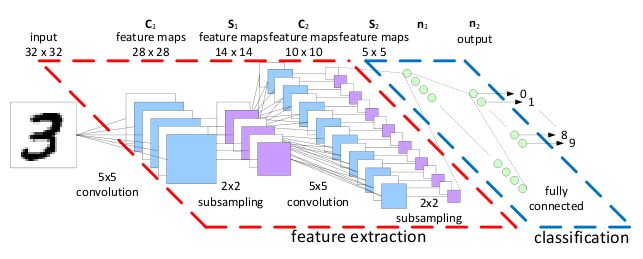
  经典的卷积神经网络是包含:输入层、卷积层、池化层、激活层、全连接层以及输出层构成的。如下图,为LeNet-5的CNN模型:
LeNet-5

————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

Socket(套接字),应用程序通常通过”套接字”向网络发出请求或者应答网络请求,使主机间或者一台计算机上的进程间可以通讯。服务器端socket()建立套接字,绑定(bind)并监听(listen),用accept()等待客户端连接。将accept()写入死循环,每次连接一个客户端,开一个线程。一般情况下建立socket连接后服务器与客户端建立了一个管道,当关闭socket或关闭客户端的时候,会导致管道破裂信号。如果使用默认处理则会导致服务器程序退出。

0. socket函数
1
socket.socket(family, type, protocol)

参数

  • family: 套接字python家族支持AF_UNIXAF_INETAF_NETLINKAF_INET

  • type: 套接字类型可以根据是面向连接的还是非连接分为SOCK_STREAMSOCK_DGRAM,其中SOCK_STREAM是tcp类型的,SOCK_DGRAM是udp类型的

  • protocol: 一般不填默认为0.


1. 简单的样例通信样例
1.1 TCP服务端

TCP是面向连接的,可靠的流协议。流就是不间断的数据结构

1
2
3
4
5
6
7
8
9
10
11
12
# for python3.X
import socket
s=socket.socket()
host=socket.gethostname() #获取主机地址,xiangdangyu
port=1234 #有效端口号是0-65535,低于1024的端口号是系统保留的
s.bind((host,port)) #绑定地址(host,port)到套接字, 在AF_INET下,以元组(host,port)的形式表示地址
s.listen(5) #开始TCP监听,操作系统可以挂起的最大连接数量;至少为1,一般设置成5即可
while True:
c,addr=s.accept() #被动接受TCP客户端连接,(阻塞式)等待连接的到来
print ("Go",addr)
c.send(('Thank you for connecting').encode()) #发送TCP数据,将string中的数据发送到连接的套接字
c.close() #关闭套接字

  由于Python2.x和Python3.x的区别,socket通信在3.x版本中需要适应encode()decode()编解码,而python3.x最重要的新特性也是对文本和二进制数据做了更清晰的区分。文本用unicode编码,为str类型,二进制数据则为bytes类型。encode(编码),可以将str类型编码为bytes。decode(译码),可以将bytes类型转换为str类型。
  注意:如果不添加encode()和decode()就会报Socket TypeError: a bytes-like object is required, not 'str'的错误,因此在发送的时候记得将数据encode(),接收的时候将数据decode()

1.2 TCP客户端
1
2
3
4
5
6
7
8
import socket
s=socket.socket()
host=socket.gethostname()
port=1234

s.connect((host,port))
data=s.recv(1024).decode() #接收TCP数据,数据以字符串形式返回,bufsize指定要接收的最大数据量。
print (s.recv(1024).decode())
1.3 UDP服务端

  UDP是一种无连接的,不具有可靠性的数据报文协议
这个是插入时间戳的例子,同理这个还可以在tcp的socket实现,各位看官自己实现吧

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# for python3.X
from socket import *
from time import ctime

host = 'localhost'
port = 12345
buffersize = 1024
addr=(host, port)
udpSocket = socket(AF_INET, SOCK_DGRAM)
udpSocket.bind(addr)
while True:
print('waiting for message...')
data, addr = udpSocket.recvfrom(buffersize)
data = data.decode()
udpSocket.sendto(('[%s] %s' % (ctime(), data)).encode(), addr)
print('...received form and return to:', addr)

udpSocket.close()
1.4 UDP客户端
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
from socket import *
from time import ctime
host='localhost'
port=12345
buffersize=1024
addr=(host, port)
udpClient=socket(AF_INET, SOCK_DGRAM)
while True:
data = input('>')
if not data:
break
udpClient.sendto(data.encode(), addr) #address是形式为(ipaddr,port)的元组,指定远程地址。返回值是发送的字节数。
data,addr=udpClient.recvfrom(buffersize)
data = data.decode()
if not data:
break
print(data)
udpClient.close()

  综上所述,可以得到这样的结论: socket通信,服务器端 要开启一个对应udp或者tcpscoket,在这个socket里面指定通信的端口的地址;udp服务器的socket这样起,udpScoket=socket(AF_INET, SOCK_DGRAM); 然后在udpSocket里面调用bind()方法绑定通信的地址addr=(host, port),也就是udpSocket.bind(addr);然后在开启一个循环通过recvfrom()方法接收udp数据,data, addr = udpSocket.recvfrom(buffersize),发送出去的话就利用sendto()方法,udpSocket.sendto(('[%s] %s' % (ctime(), data)).encode(), addr)。tcp的socket相对于udp的socket是一种可靠的传输,在起socket的时候不同于udp的主要有两点,一是利用SOCK_STREAM,二是tcp的通信需要在一段时间内监听通信端口是否有数据发来,这是tcp协议所特有的。客户端 服务器端开启了socket服务之后,socket客户端需要对应服务器开启一个对应的socket客户端:tcp开udpClient=socket(AF_INET, SOCK_STREAM),然后让这个客户端的socket连接到服务器的socket;也就是tcpClient.connect(ADDR)' 这里ADDR=(host, port)udpClient=socket(AF_INET, SOCK_DGRAM)这样客户端就和服务器连接起来了;客户端样用recv()方法接收服务器的数据;用send()方法将数据发送到服务器。udp客户同tcp的方法一样,跟对应模式的socket`方法一直,端口对端口,地址对地址。


2、socketserver模块

  socketserver是标准库中的一个高级模块,用于网络客户端与服务器的实现,模块定义了一些类来处理诸如TCP、UDP、UNIX流和UNIX数据报之上的同步网络请求。;python3中,导入socketserver模块, 使用import socketserver. 在使用socketserver的时候必须说先定义一个继承BaseRequestHandler的处理类。

socketserver 模块中包含的类

  • BaseServer  包含服务器的核心功能与混合类(min-in)的钩子功能.这个类主用于派生,不要直接生成这个类的类对象,可以考虑使用;

  • TCPServer/UDPServerTCPServer基本的网络同步tcp服务器/UDPServer 基本的网络同步udp服务器;

  • ForkingMinIn  实现了核心的进程化功能,用于与服务器类进行混合(min-in),以提供一些异步特性.不要直接生成这个类的对象;

  • ThreadingMinIn 实现了核心的线程化功能,用于与服务器类进行混合(min-in),以提供一些异步特性,不要直接生成这个类的对象;

  • ForkingTCPServer/ForkingUDPServerForkingMinInTCPServer的组合/ForkingMinInUDPServer的组合;

  • BaseRequestHandler  无法创建这个类的实例,可以使用 StreamRequestHandlerDataStreamRequestHandler 创建类的实例;

  • StreamRequestHandler/DataStreamRequestHandler  tcp请求处理类的一个实现/udp请求处理类的一个实现;

socket线程池
附表

socket属性模块

服务器端套接字*通用函数

函数名 函数名
s.bind() 绑定地址(host,port)到套接字,在AF_INET下,以元组(host,port)的形式表示地址
s.listen() 开始TCP监听。backlog指定在拒绝连接之前,操作系统可以挂起的最大连接数量。该值至少为1,大部分应用程序设为5就可以了
s.accept() 被动接受TCP客户端连接,(阻塞式)等待连接的到来客户端套接字
s.connect() 主动初始化TCP服务器连接,一般address的格式为元组(hostname,port),如果连接出错,返回socket.error错误
s.connect_ex() 函数的扩展版本,出错时返回出错码,而不是抛出异常


————-本文结束感谢您的阅读————-

坚持创作,坚持分享!

打赏


    ![liurui 微信支付](/images/wechatpay.png)
    

微信支付

    ![liurui 支付宝](/images/alipay.png)
    

支付宝

0%